und OpenAI.
Vorgestellt
Logfire unterstützt die Verwendung einer zusätzlichen Codezeile zur Erkennung von OpenAI-Aufrufen.
import openai
import logfire

client = openai.Client()

logfire.configure()
logfire.instrument_openai(client)  # (1)!

response = client.chat.completions.create(
    model='gpt-4',
    messages=[
        {'role': 'system', 'content': 'You are a helpful assistant.'},
        {'role': 'user', 'content': 'Please write me a limerick about Python logging.'},
    ],
)
print(response.choices[0].message)
-
Wenn Sie keinen Zugriff auf die Clientinstanz haben, können Sie entweder eine Klasse übergeben (z. B.
logfire.instrument_openai(openai.Client)) oder keine Parameter übergeben (z. B.logfire.instrument_openai()), um die Klassenopenai。客户端undopenai。AsyncClientzu erkennen.
_
Weitere Informationen finden Sie unter [instrument_openai() API-Referenz][logfire. instrument_openai].
Mit ihm können Sie bekommen:
-
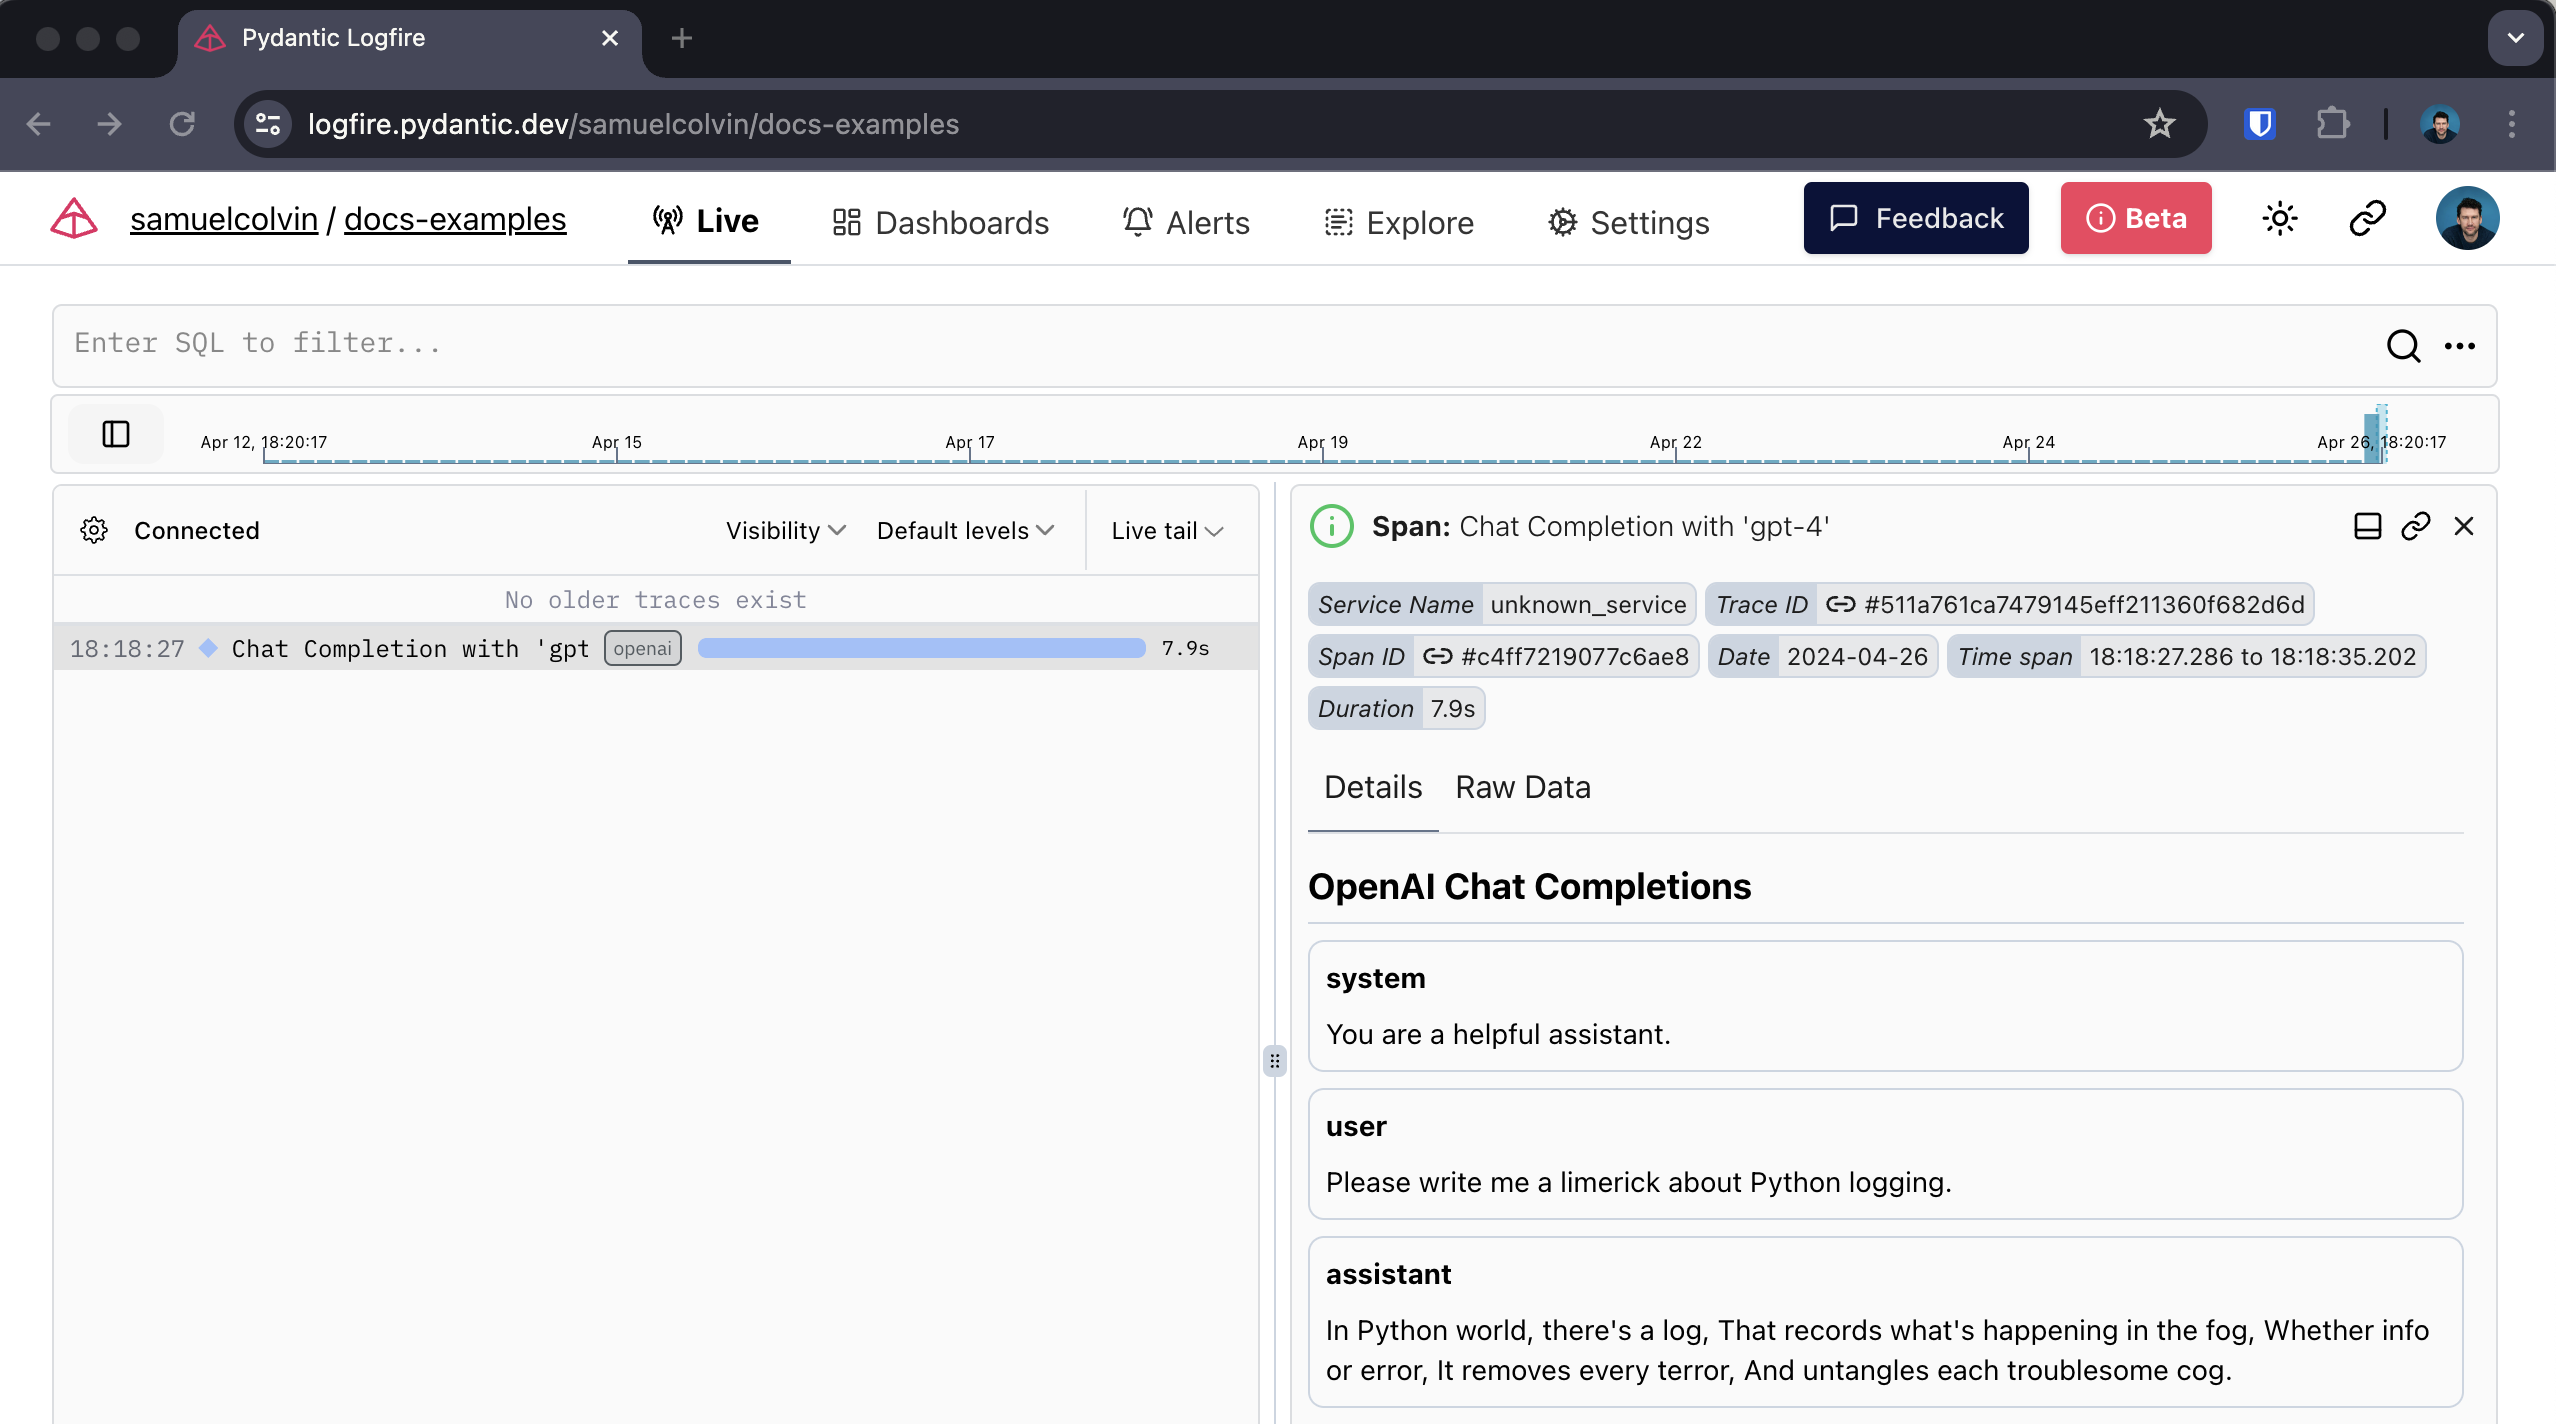
Um die Spanne eines Aufrufs an OpenAI herum wird die Dauer aufgezeichnet und etwaige Ausnahmen erfasst.
-
Vom Menschen lesbare Displays für Gespräche mit einem Sitzplatz
-
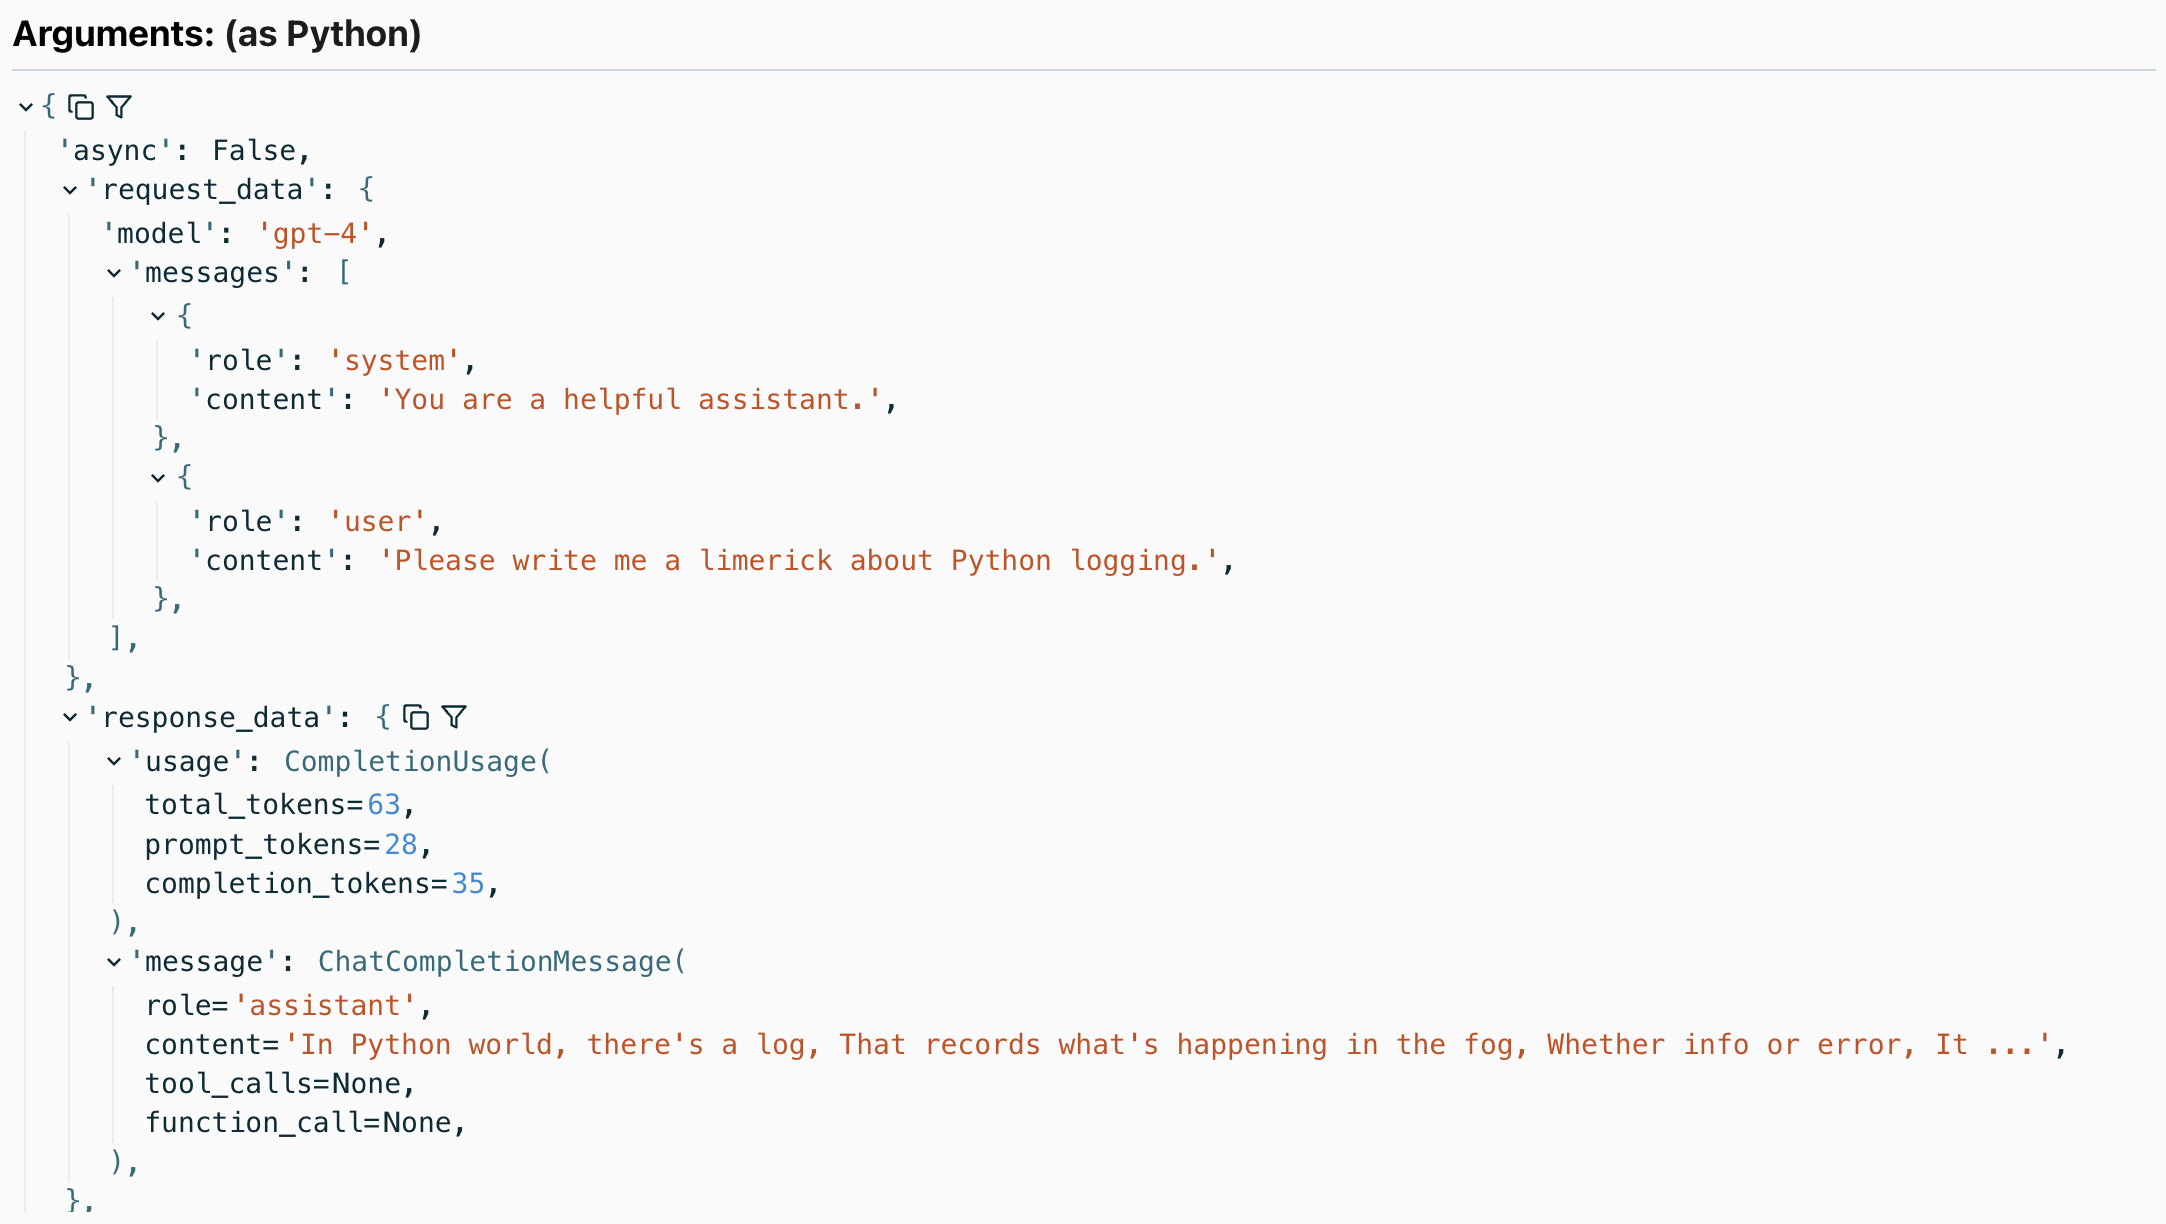
Details der Antworten, einschließlich der Anzahl der verwendeten Token
Die abgedeckten Methoden
Dies umfasst die folgenden OpenAI-Methoden:
-
client.chat.completions.create- Ja und Nein.stream=True -
client.completions.create- Ja und nein.stream=True client.embeddings.createclient.images.generate
Alle Methoden sind darin enthalten. openai 中。客户端 und openai。AsyncClient。
Im Folgenden finden Sie beispielsweise die Erkennung eines Bildgenerierungsaufrufs:
import openai
import logfire

async def main():
    client = openai.AsyncClient()
    logfire.configure()
    logfire.instrument_openai(client)

    response = await client.images.generate(
        prompt='Image of R2D2 running through a desert in the style of cyberpunk.',
        model='dall-e-3',
    )
    url = response.data[0].url
    import webbrowser
    webbrowser.open(url)

if __name__ == '__main__':
    import asyncio
    asyncio.run(main())
für:
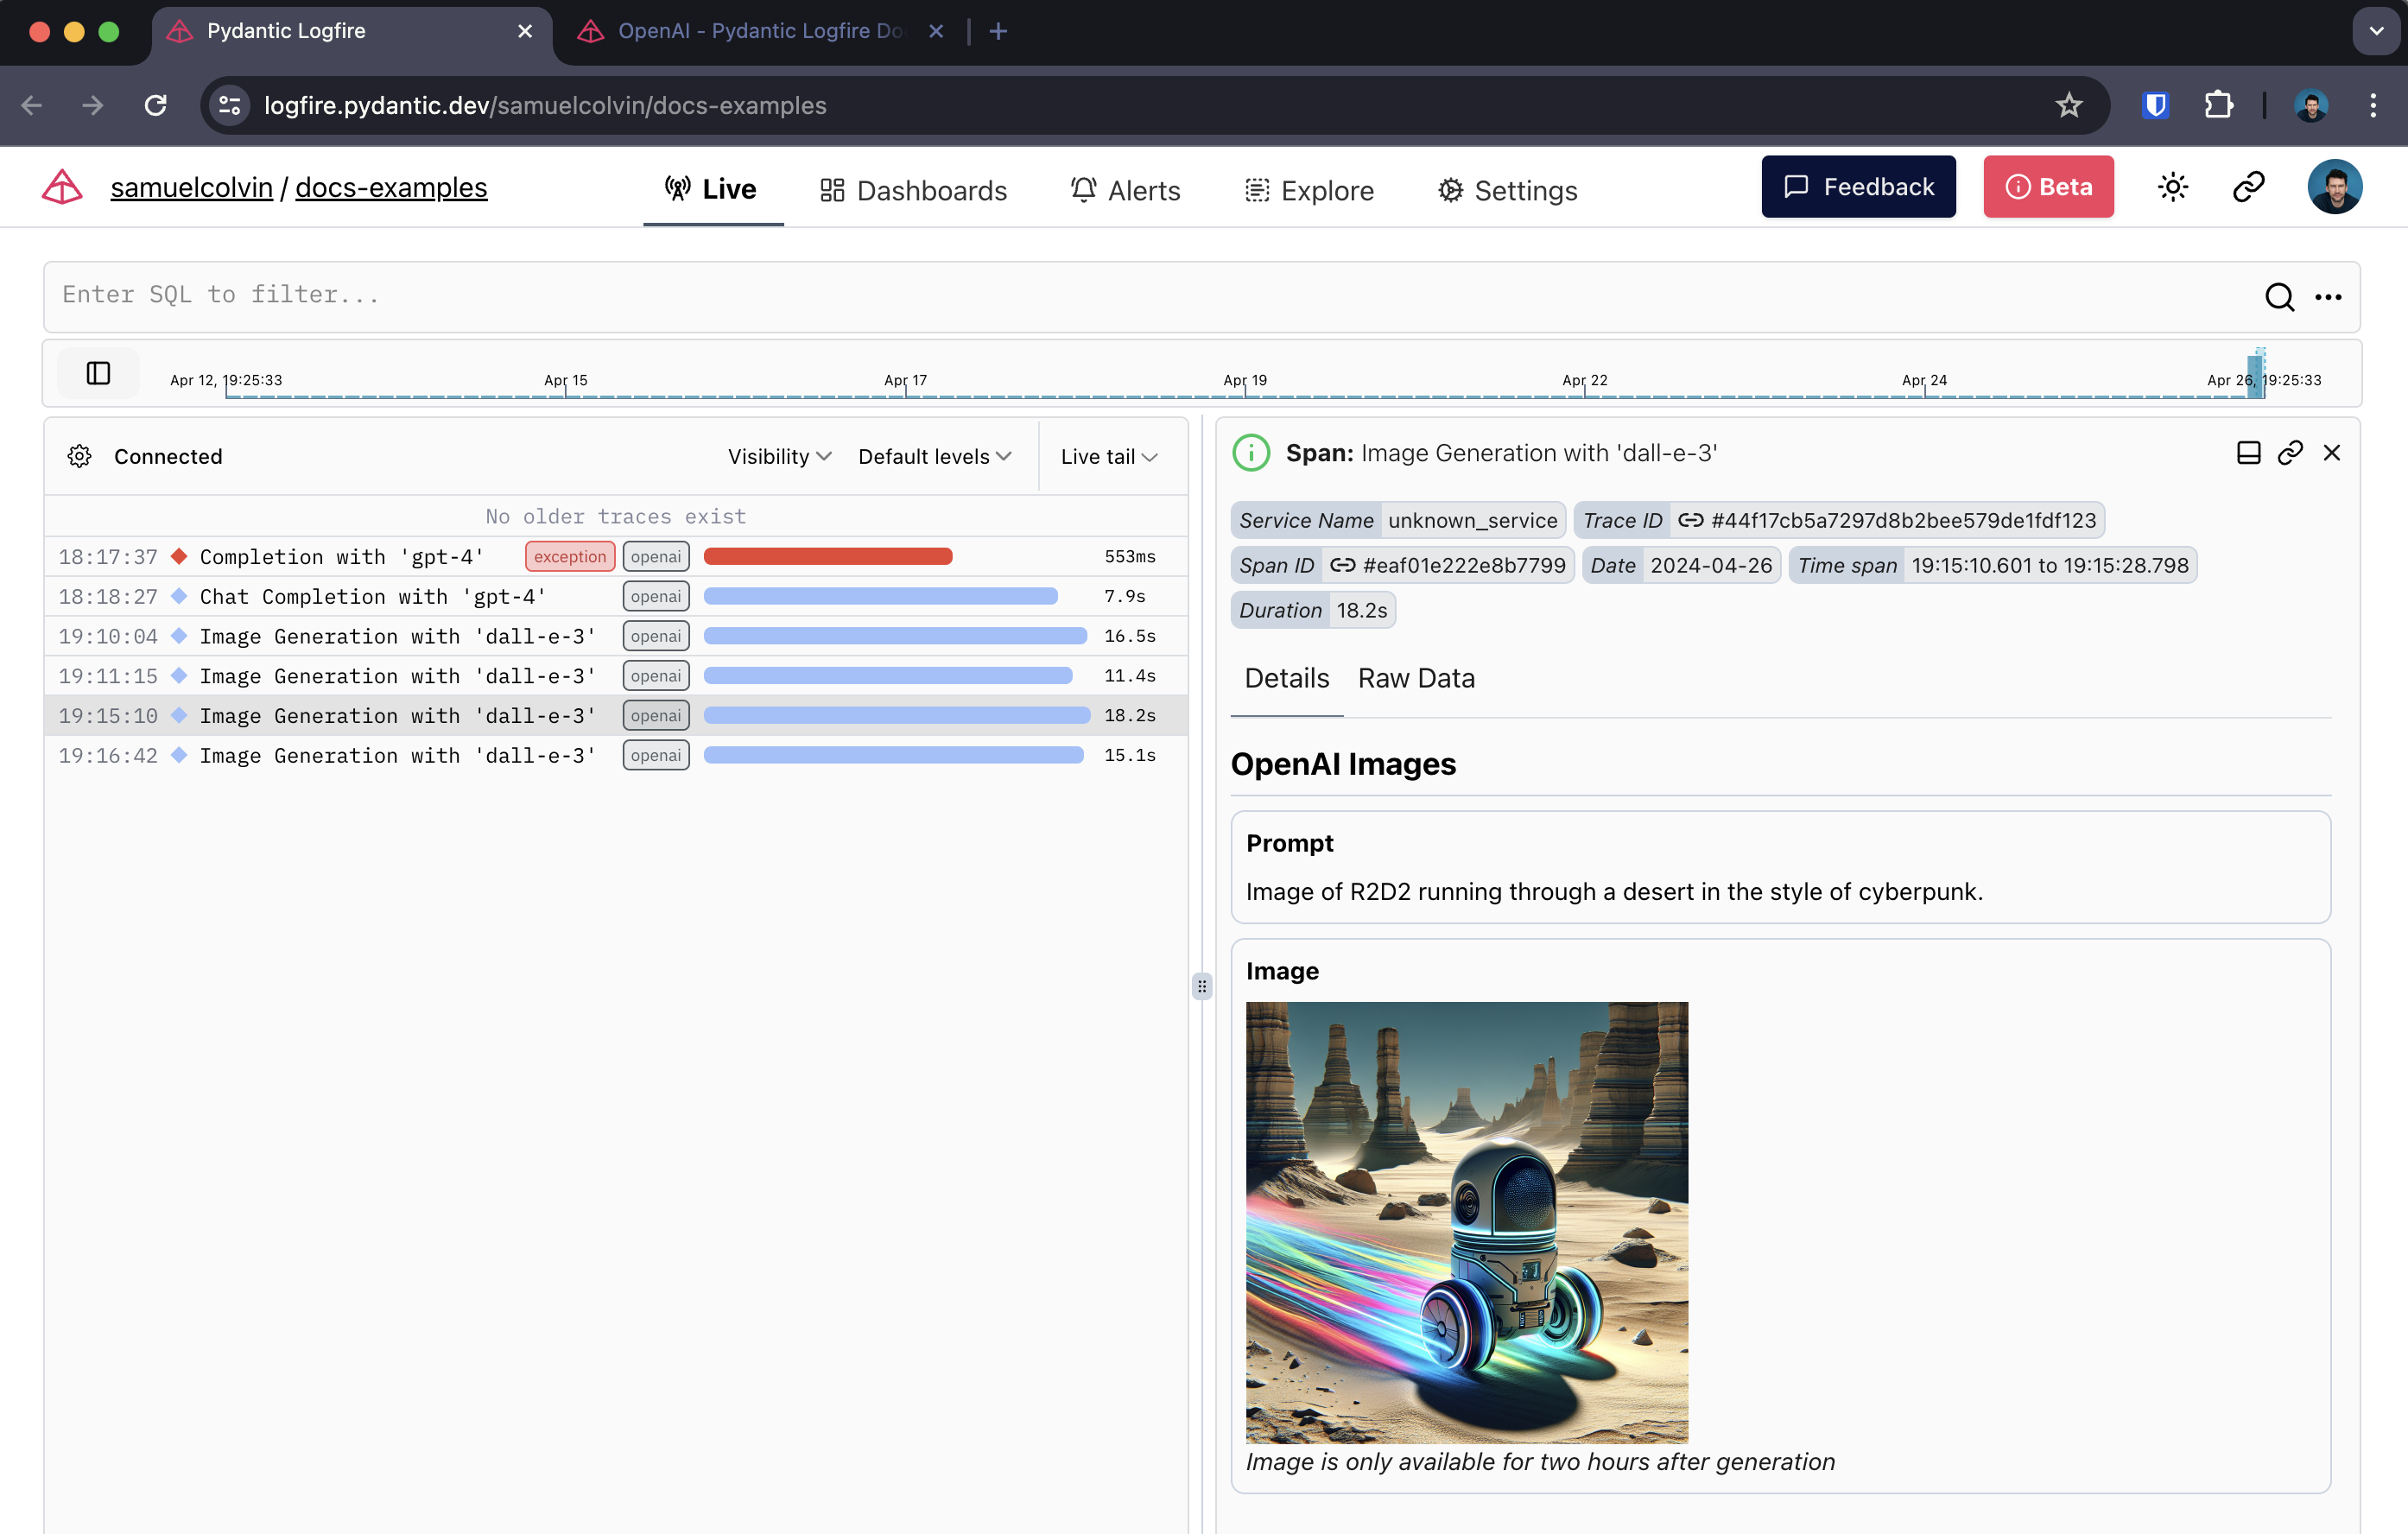
OpenAI Bilder werden erweitert
Stream antworten
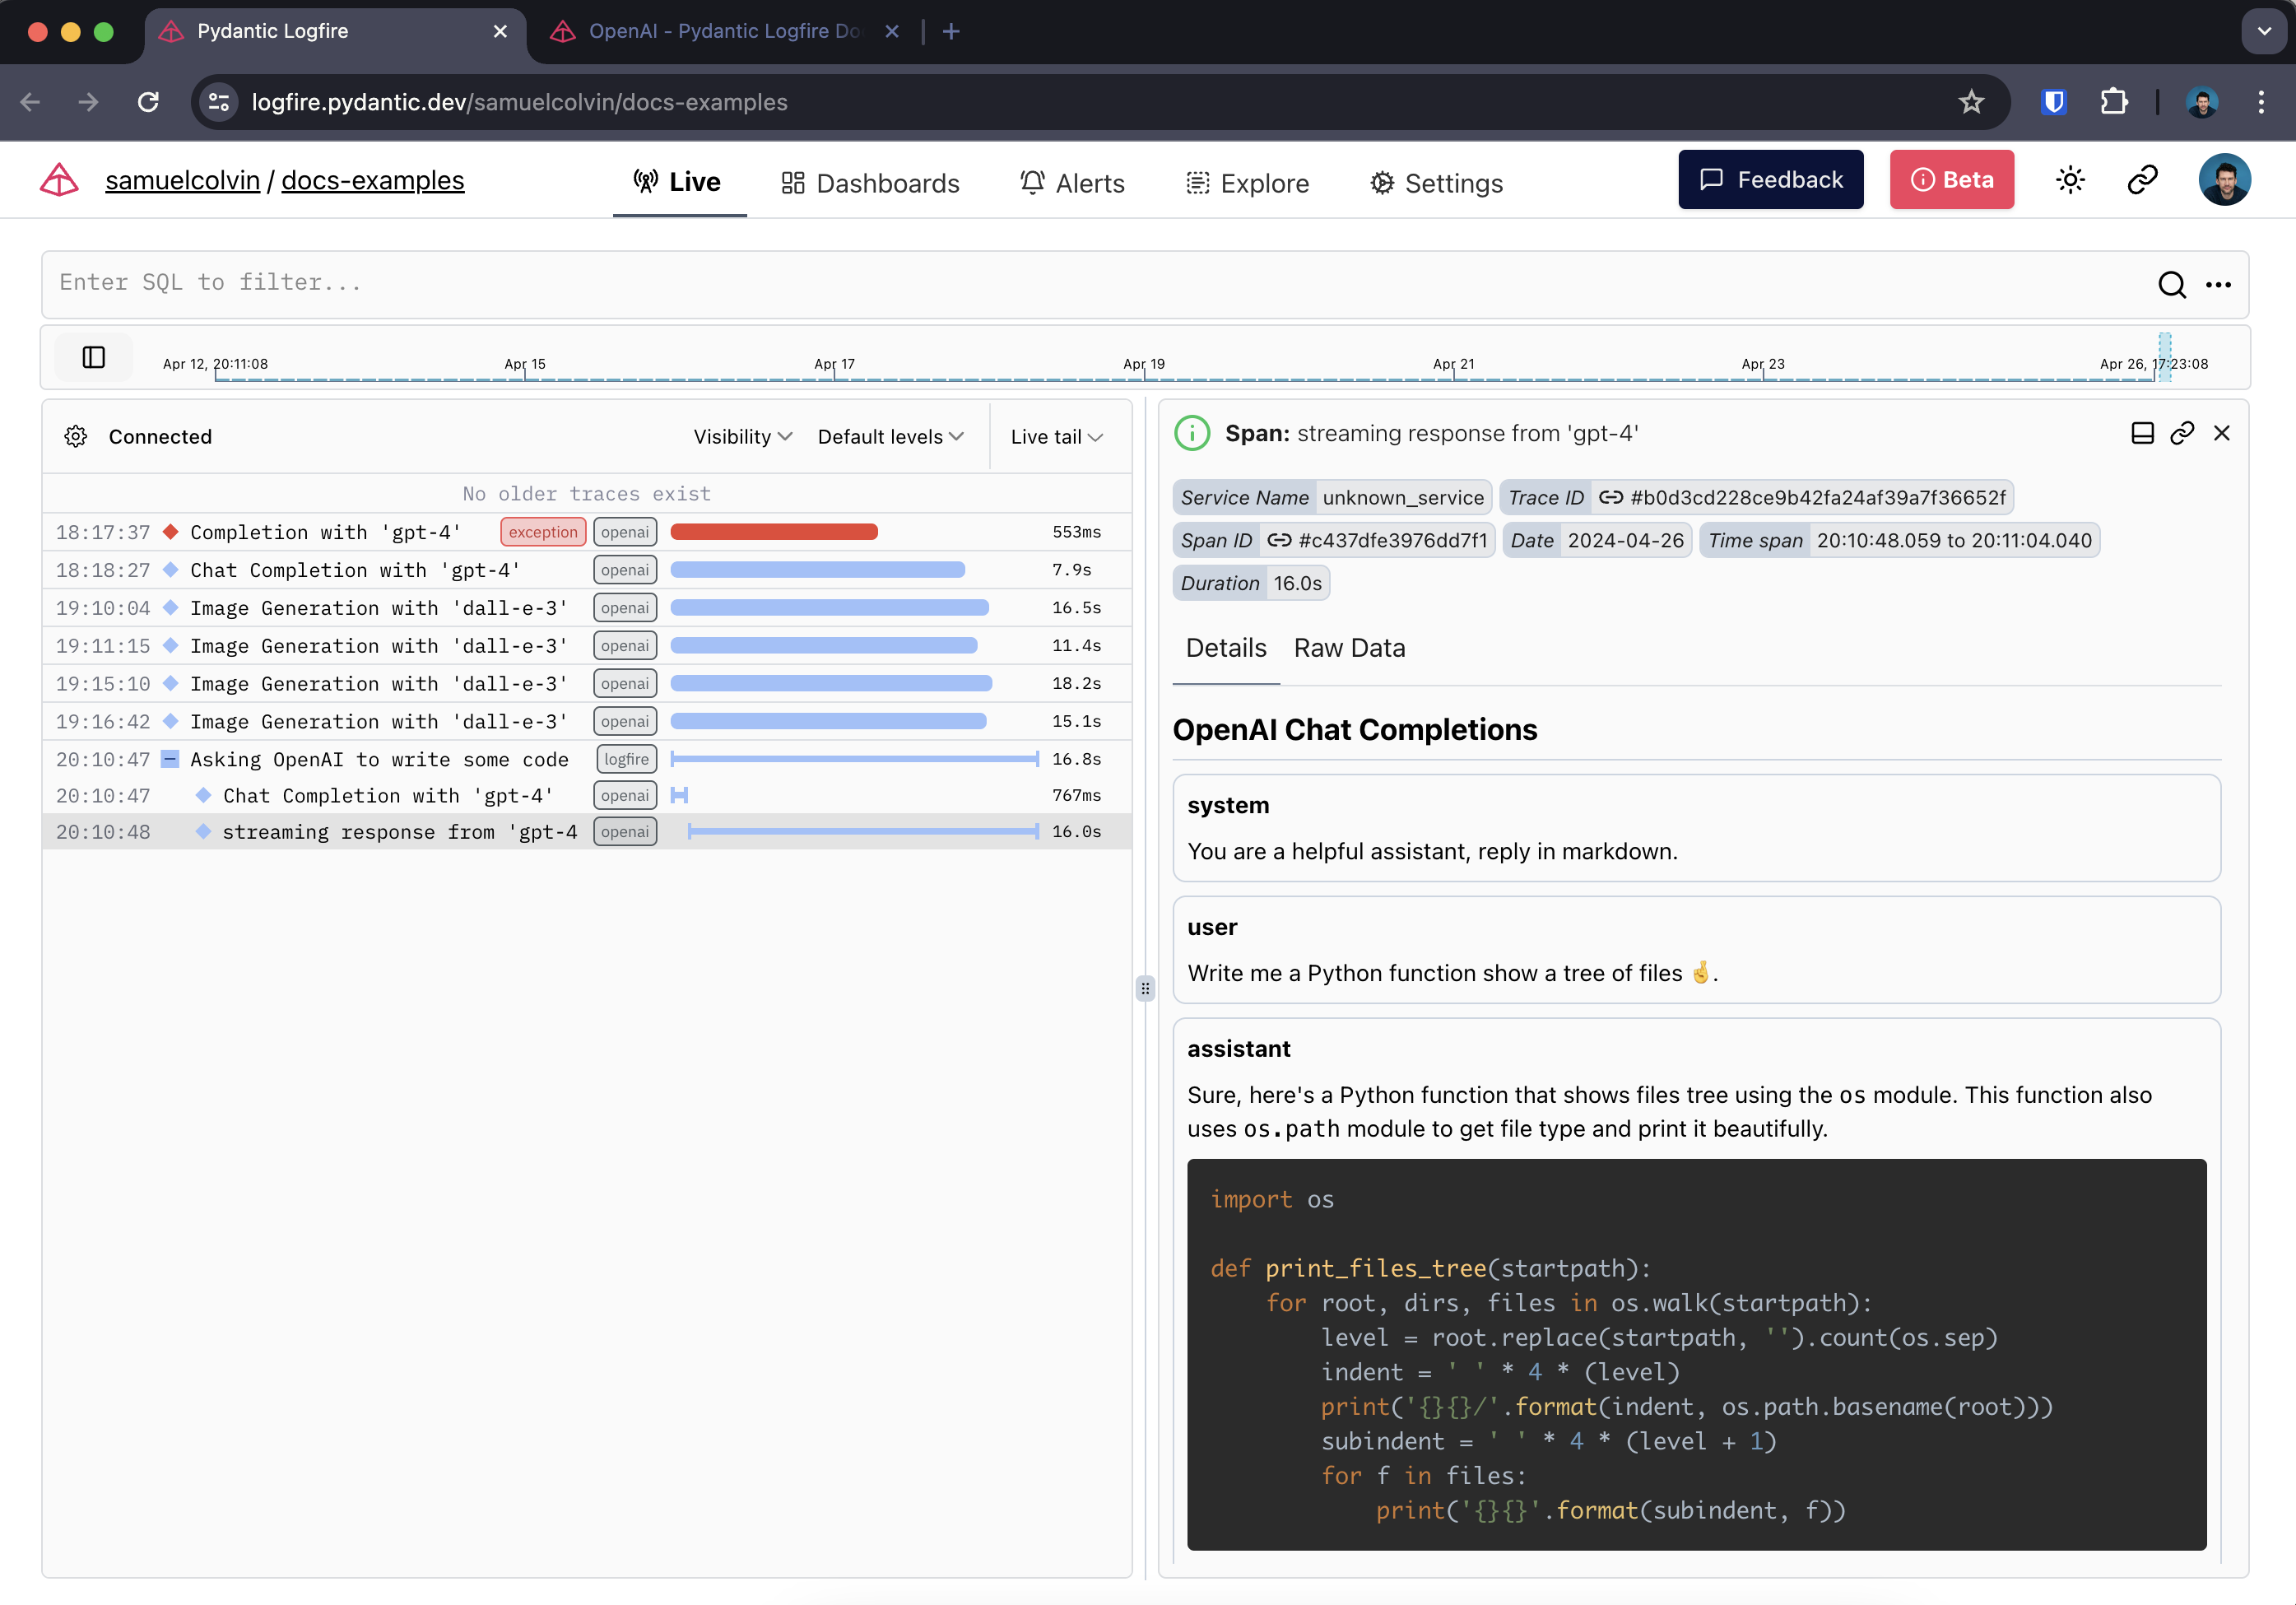
Bei der Erkennung von Streaming-Antworten erstellt Logfire zwei Spulen-eine um die ursprüngliche Anfrage und eine um die Streaming-Antwort.
Hier verwenden wir Rich. Live und Markdown Typ Rendering Antwort in Echtzeit im Terminal: Tänzer:.
import openai
import logfire
from rich.console import Console
from rich.live import Live
from rich.markdown import Markdown

client = openai.AsyncClient()
logfire.configure()
logfire.instrument_openai(client)

async def main():
    console = Console()
    with logfire.span('Asking OpenAI to write some code'):
        response = await client.chat.completions.create(
            model='gpt-4',
            messages=[
                {'role': 'system', 'content': 'Reply in markdown one.'},
                {'role': 'user', 'content': 'Write Python to show a tree of files 🤞.'},
            ],
            stream=True
        )
        content = ''
        with Live('', refresh_per_second=15, console=console) as live:
            async for chunk in response:
                if chunk.choices[0].delta.content is not None:
                    content += chunk.choices[0].delta.content
                    live.update(Markdown(content))

if __name__ == '__main__':
    import asyncio
    asyncio.run(main())
In Logfire sieht es wie folgt aus:
本文总阅读量次