par OpenAI
Introduction à
Logfire prend en charge l'utilisation d'une ligne de code supplémentaire pour détecter les appels à OpenAI.
import openai
import logfire

client = openai.Client()

logfire.configure()
logfire.instrument_openai(client)  # (1)!

response = client.chat.completions.create(
    model='gpt-4',
    messages=[
        {'role': 'system', 'content': 'You are a helpful assistant.'},
        {'role': 'user', 'content': 'Please write me a limerick about Python logging.'},
    ],
)
print(response.choices[0].message)
-
Si vous n'avez pas accès à l'instance client, vous pouvez passer une classe (par exemple
logfire.instrument_openai(openai.Client)) ou détecter les classesopenai。客户端etopenai。AsyncClientsans passer d'argument (par exemplelogfire.instrument_openai()).
_
Pour plus d'informations, voir [instrument_openai() API reference][logfire. Logfire.instrument_openai].
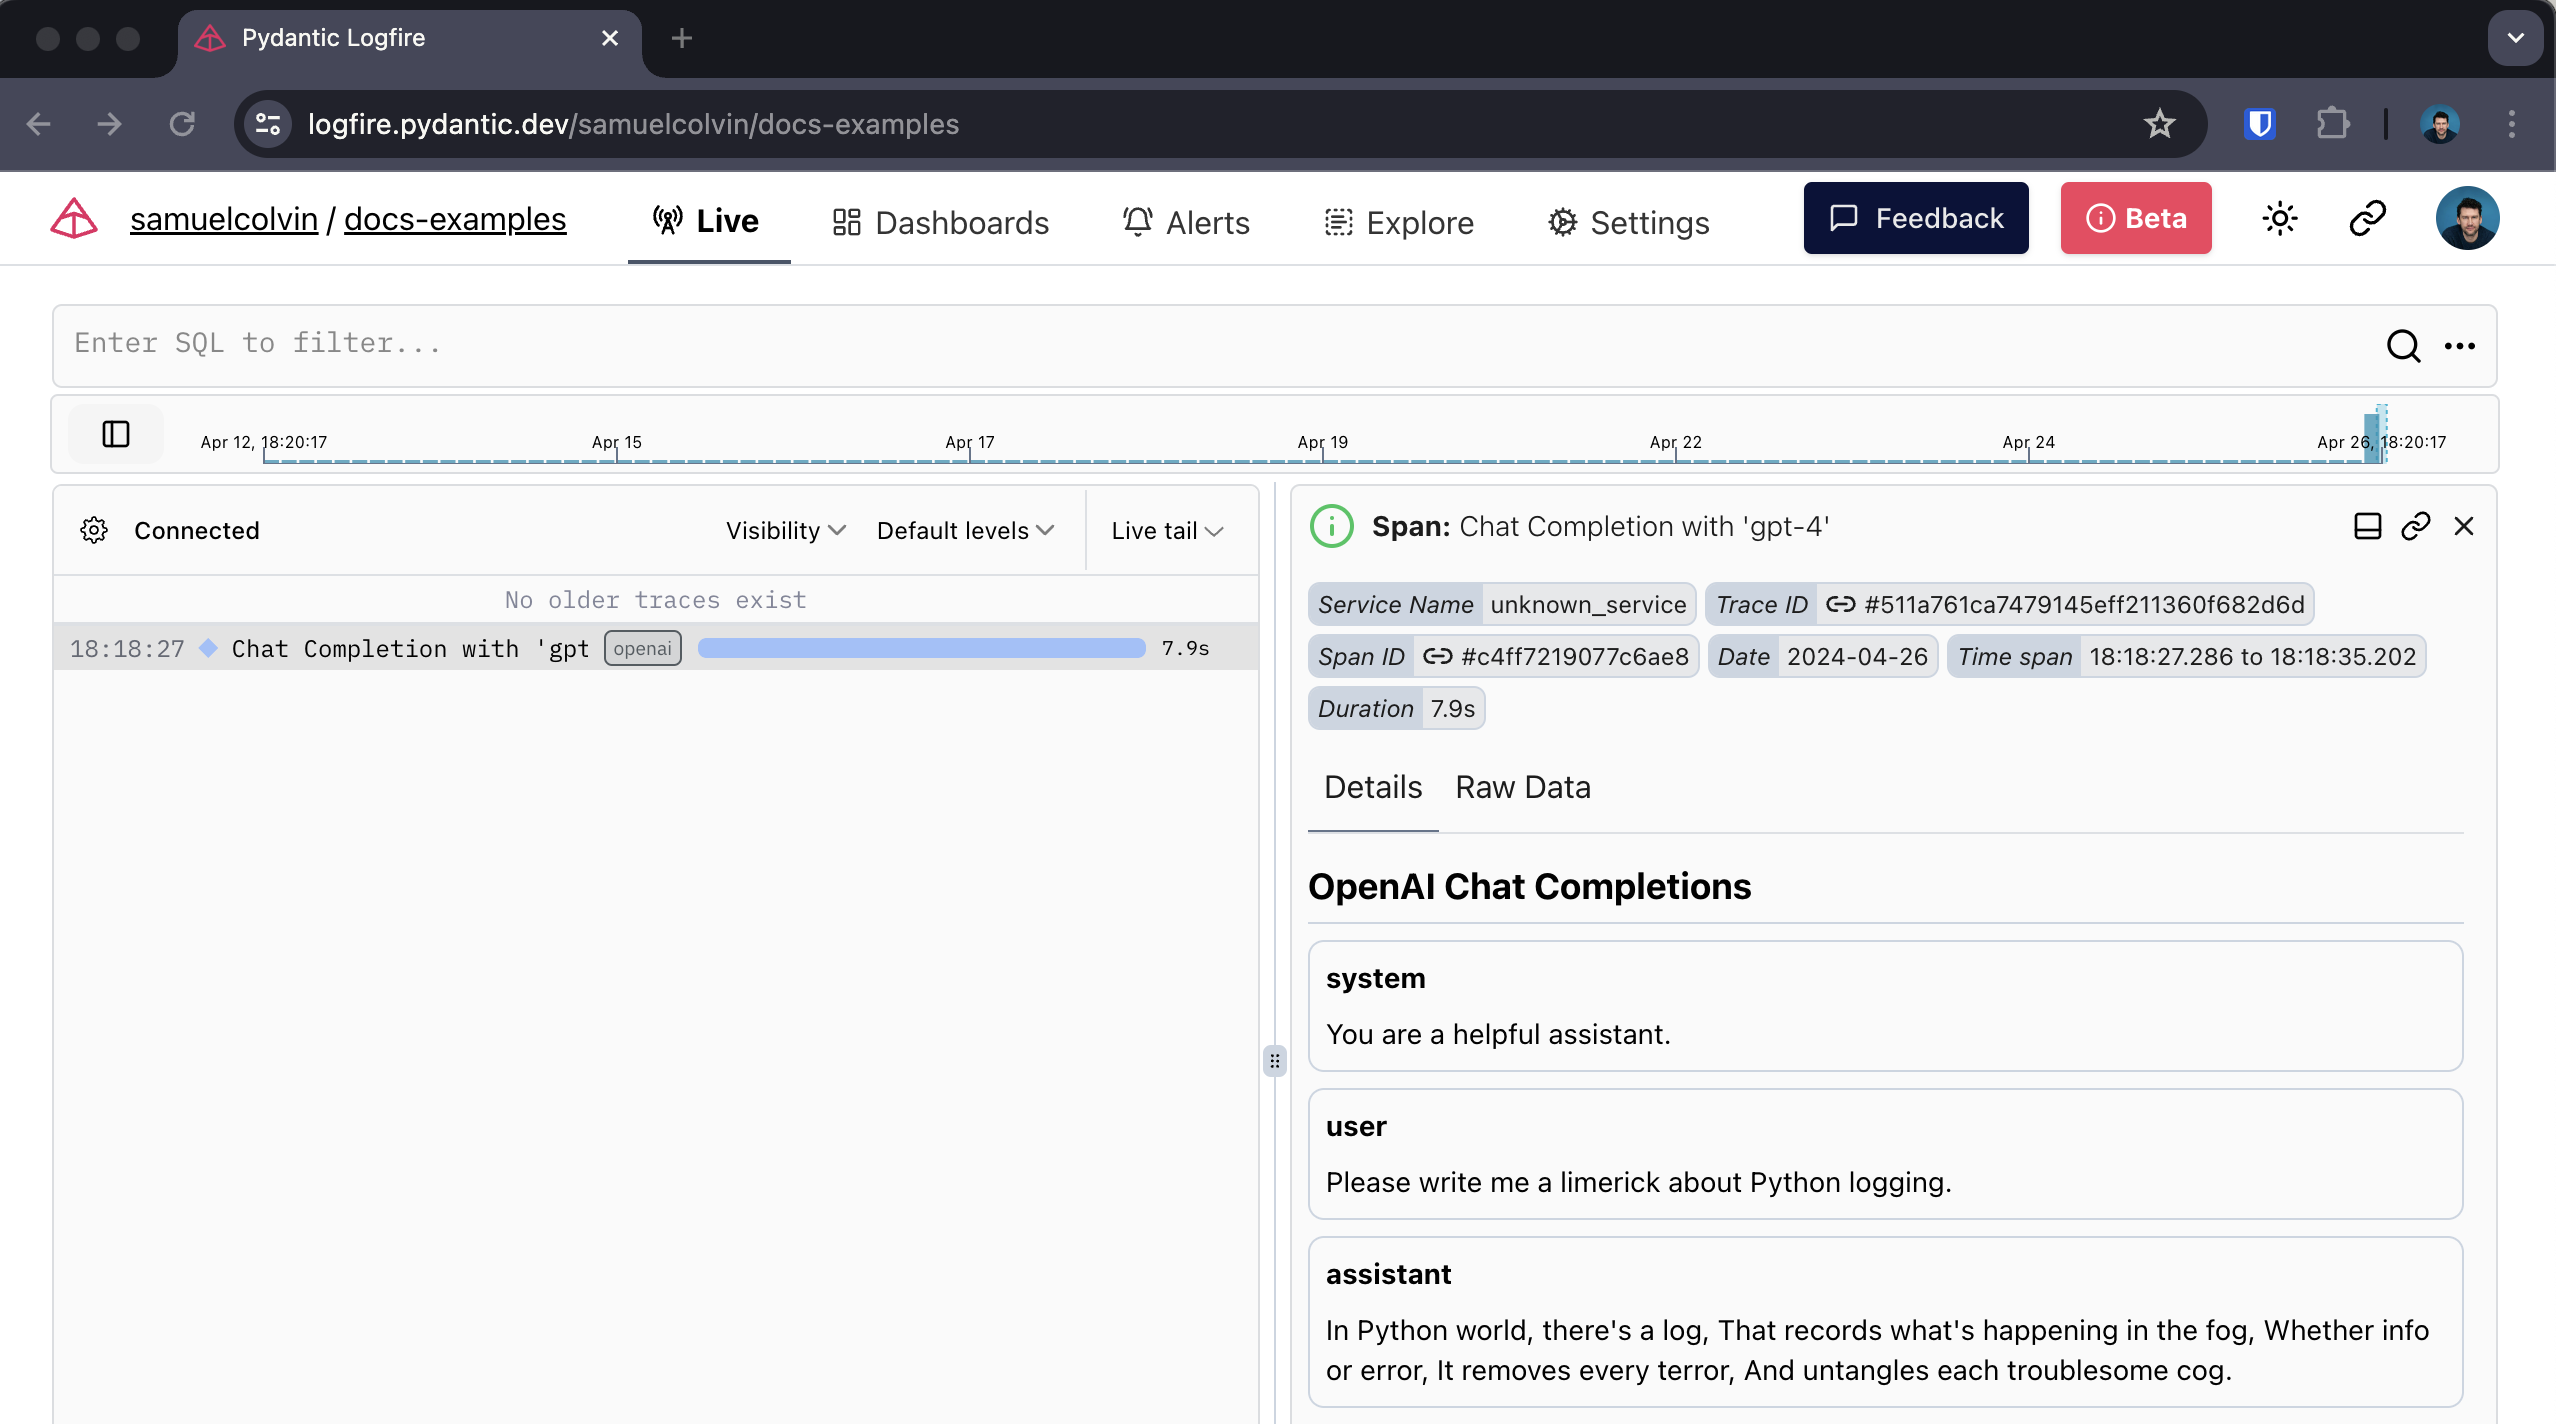
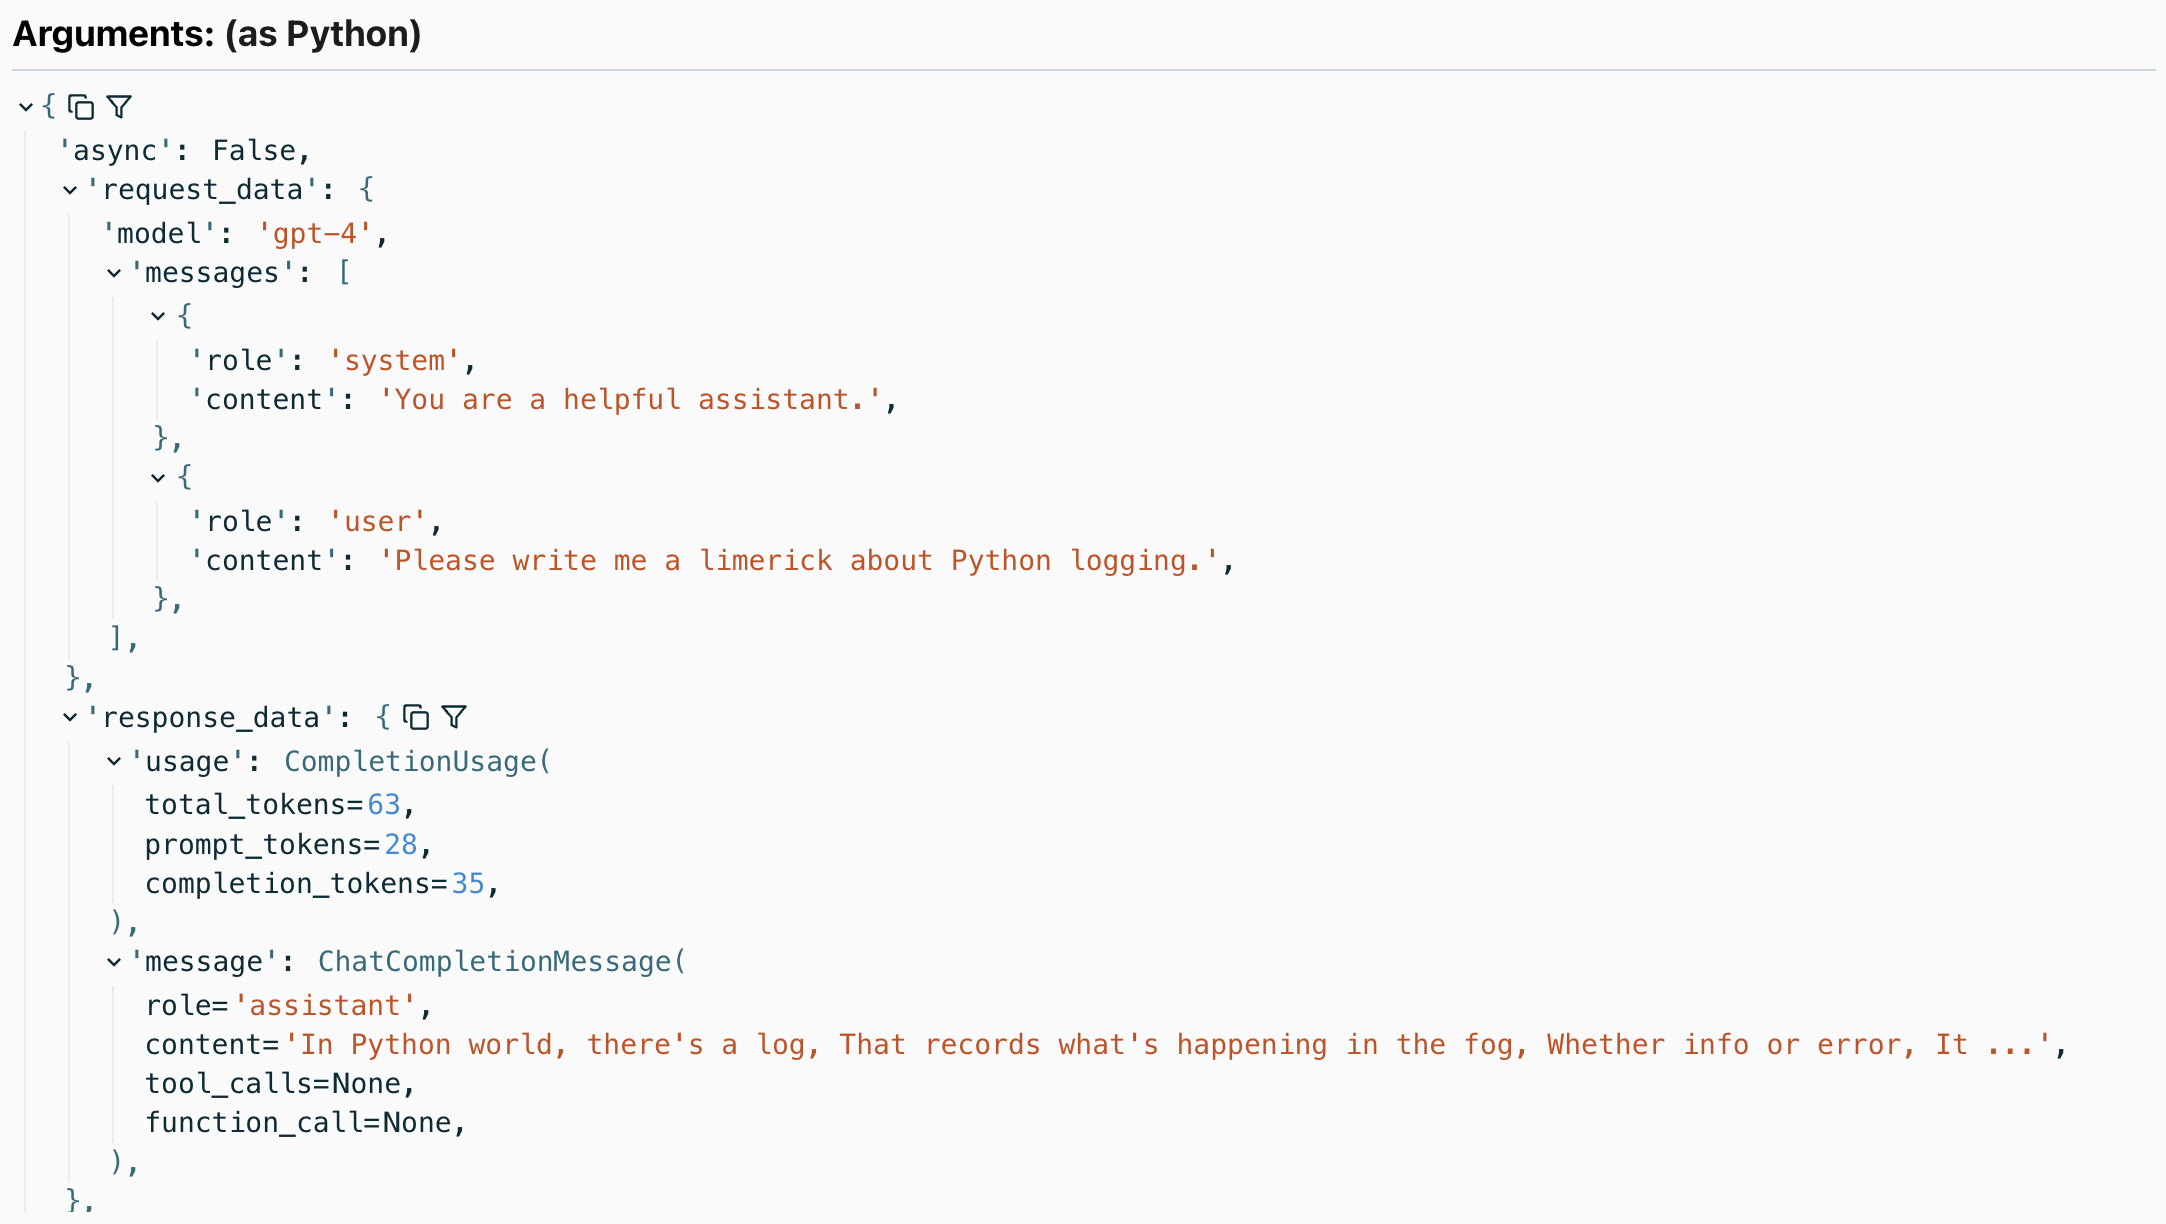
Avec cela, vous pouvez obtenir:
-
La durée autour d'un appel à OpenAI qui enregistre la durée et capture toute anomalie qui pourrait se produire
-
Affichage lisible par l'homme des conversations avec les agents
-
Détails de la réponse, y compris le nombre de jetons utilisés
Méthodes couvertes
Les méthodes OpenAI suivantes sont couvertes:
-
client.chat.completions.create- Avec et sansstream=True -
client.completions.create- Avec et sansstream=True client.embeddings.createclient.images.generate
Toutes les méthodes sont contenues dans openai 中。客户端 et openai。AsyncClient.
Par exemple, voici la détection d'un appel de génération d'image:
import openai
import logfire

async def main():
    client = openai.AsyncClient()
    logfire.configure()
    logfire.instrument_openai(client)

    response = await client.images.generate(
        prompt='Image of R2D2 running through a desert in the style of cyberpunk.',
        model='dall-e-3',
    )
    url = response.data[0].url
    import webbrowser
    webbrowser.open(url)

if __name__ == '__main__':
    import asyncio
    asyncio.run(main())
Donner à:
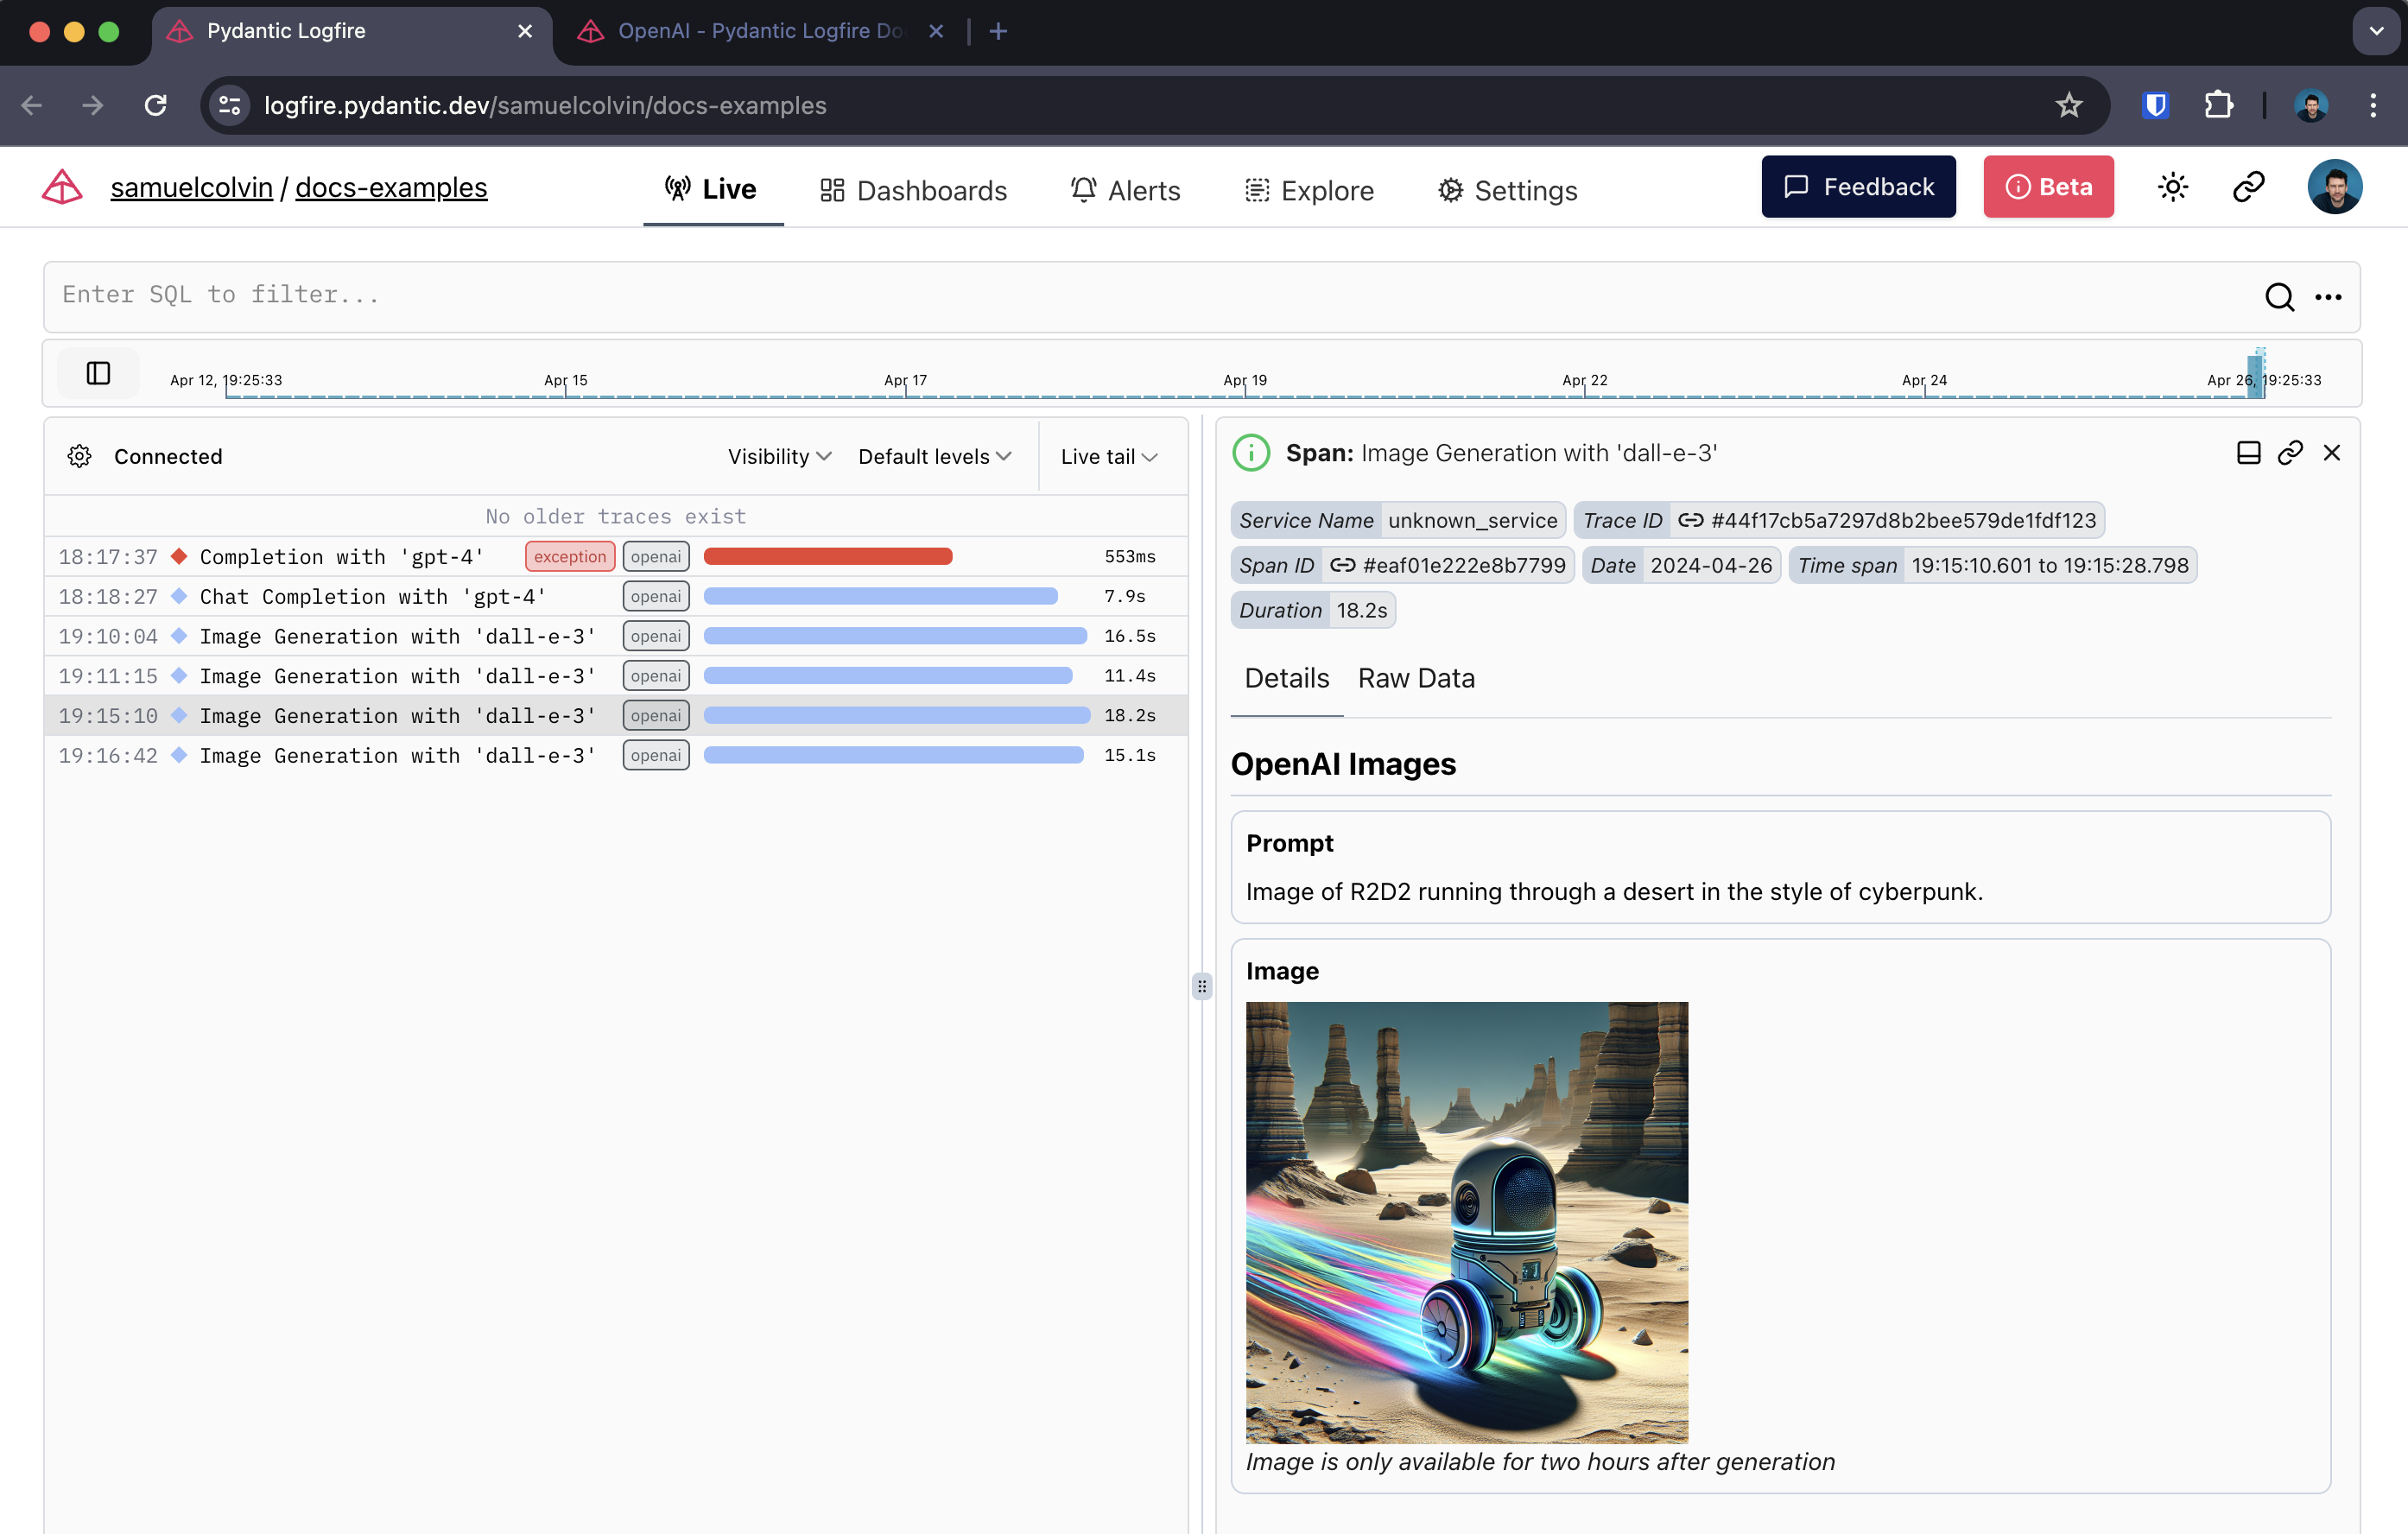
Génération d'images par OpenAI
Stream réponse
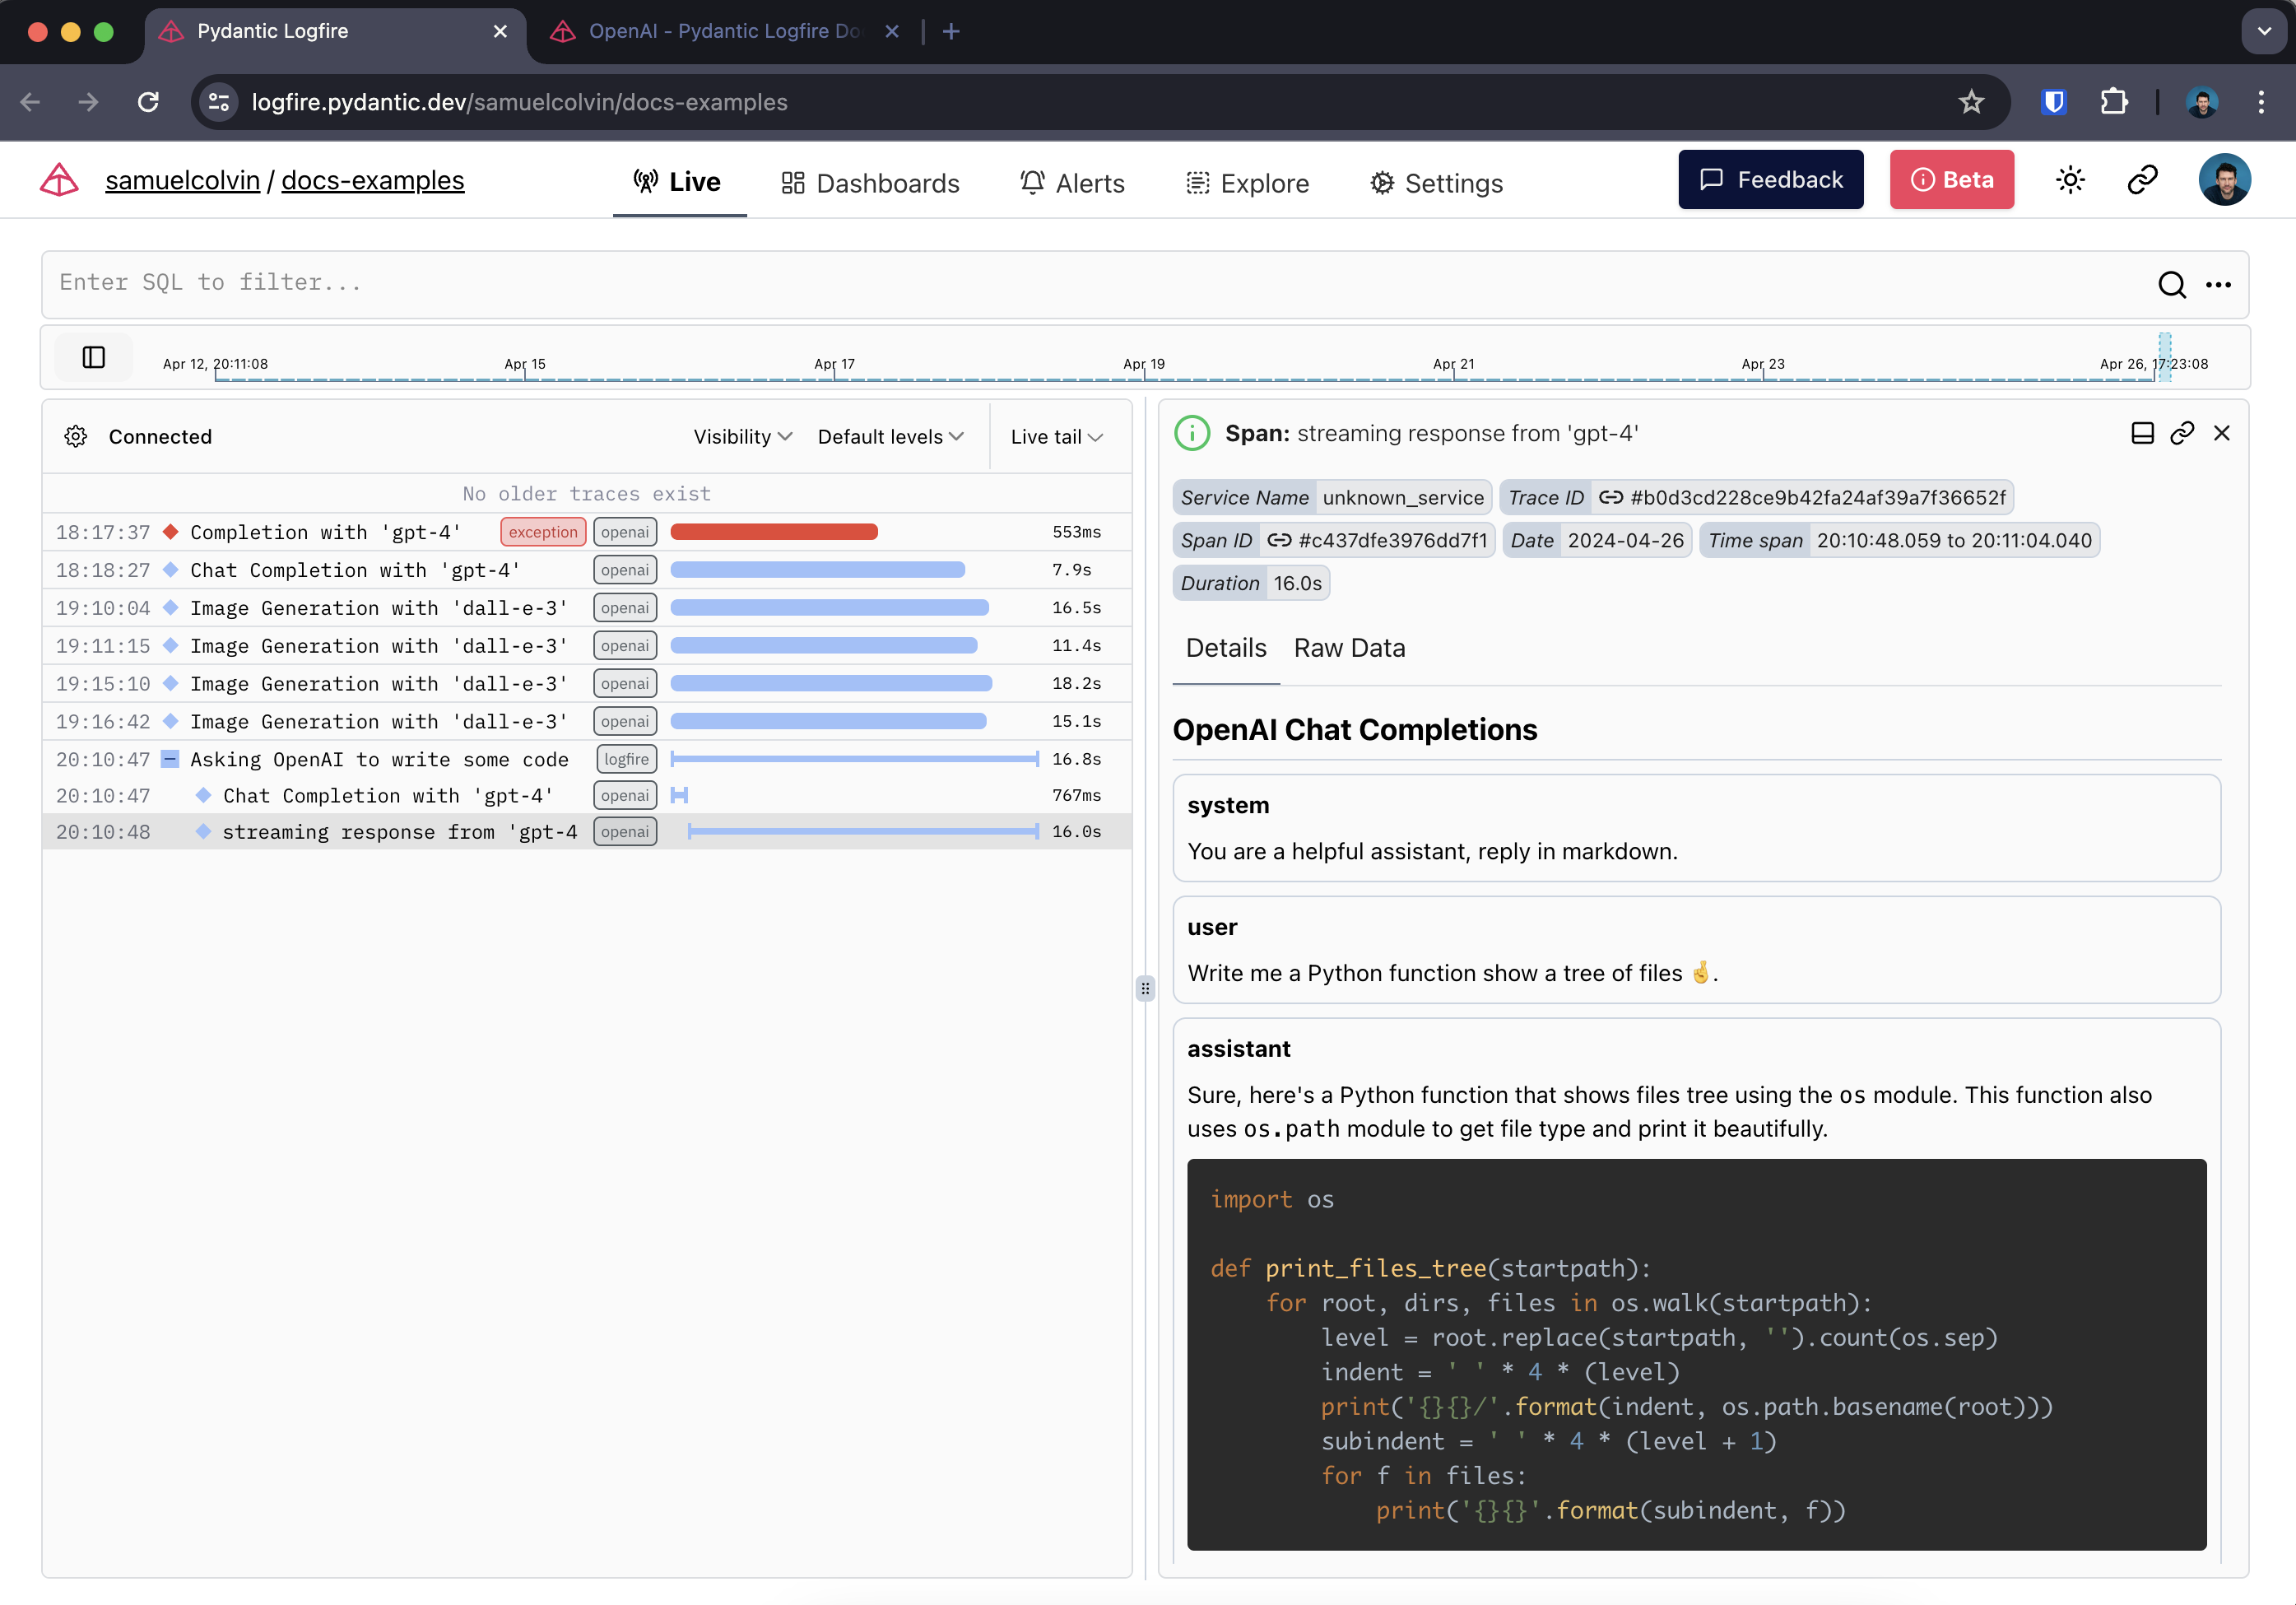
Lors de la détection d'une réponse de flux, Logfire crée deux spreads-un autour de la demande initiale et un autour de la réponse de flux.
Ici, nous utilisons également Rich Live et Markdown Les types rendent les réponses en temps réel dans le terminal.: Danseur:
import openai
import logfire
from rich.console import Console
from rich.live import Live
from rich.markdown import Markdown

client = openai.AsyncClient()
logfire.configure()
logfire.instrument_openai(client)

async def main():
    console = Console()
    with logfire.span('Asking OpenAI to write some code'):
        response = await client.chat.completions.create(
            model='gpt-4',
            messages=[
                {'role': 'system', 'content': 'Reply in markdown one.'},
                {'role': 'user', 'content': 'Write Python to show a tree of files 🤞.'},
            ],
            stream=True
        )
        content = ''
        with Live('', refresh_per_second=15, console=console) as live:
            async for chunk in response:
                if chunk.choices[0].delta.content is not None:
                    content += chunk.choices[0].delta.content
                    live.update(Markdown(content))

if __name__ == '__main__':
    import asyncio
    asyncio.run(main())
Dans Logfire, cela ressemble à ceci:
本文总阅读量次