OpenAI.
Презентация
Logfire поддерживает дополнительную строку кода для обнаружения вызовов OpenAI.
import openai
import logfire

client = openai.Client()

logfire.configure()
logfire.instrument_openai(client)  # (1)!

response = client.chat.completions.create(
    model='gpt-4',
    messages=[
        {'role': 'system', 'content': 'You are a helpful assistant.'},
        {'role': 'user', 'content': 'Please write me a limerick about Python logging.'},
    ],
)
print(response.choices[0].message)
-
Если вы не можете получить доступ к экземпляру клиента, вы можете передать класс (например,
logfire.instrument_openai(openai.Client)) или не передавать параметры (например,logfire.instrument_openai()) для обнаружения классовopenai。客户端иopenai。AsyncClient.
Для получения дополнительной информации см.instrument_openai() Ссылка на API)[logfire. instrument_openai].
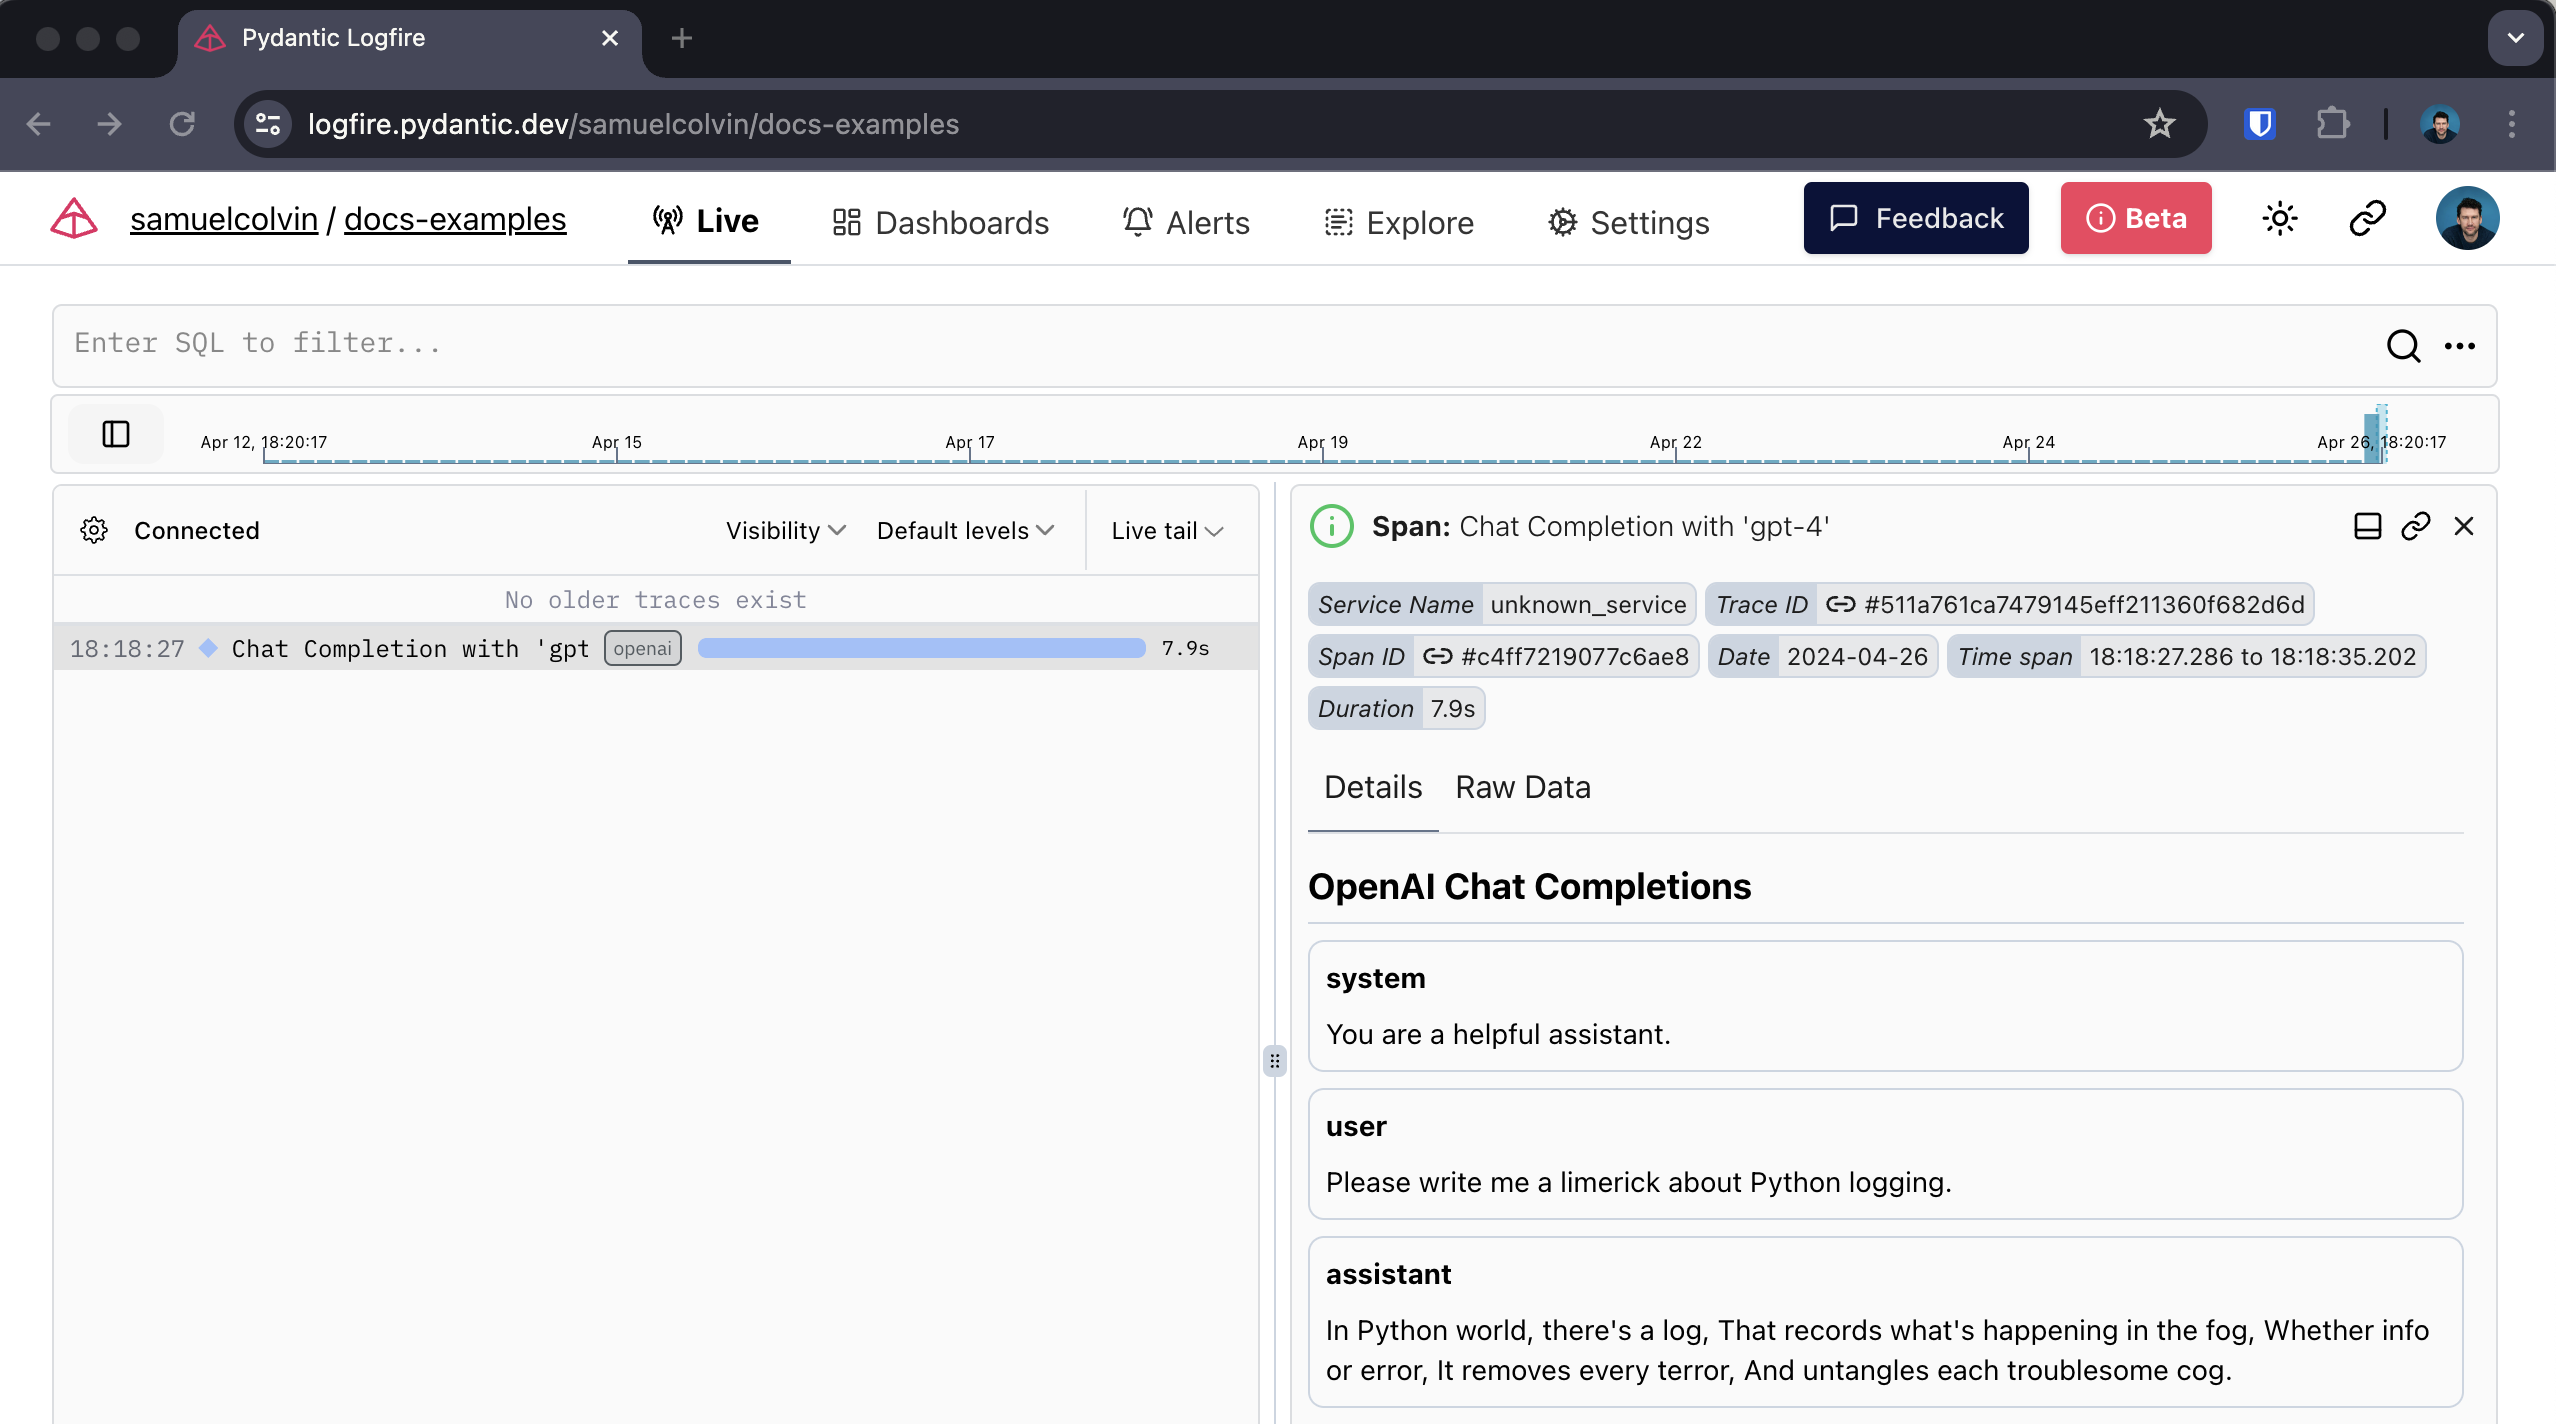
С его помощью вы можете получить:
-
Вокруг диапазона вызова OpenAI, который записывает продолжительность и фиксирует любые исключения, которые могут произойти
-
Человеческое читаемое отображение диалога с столом
-
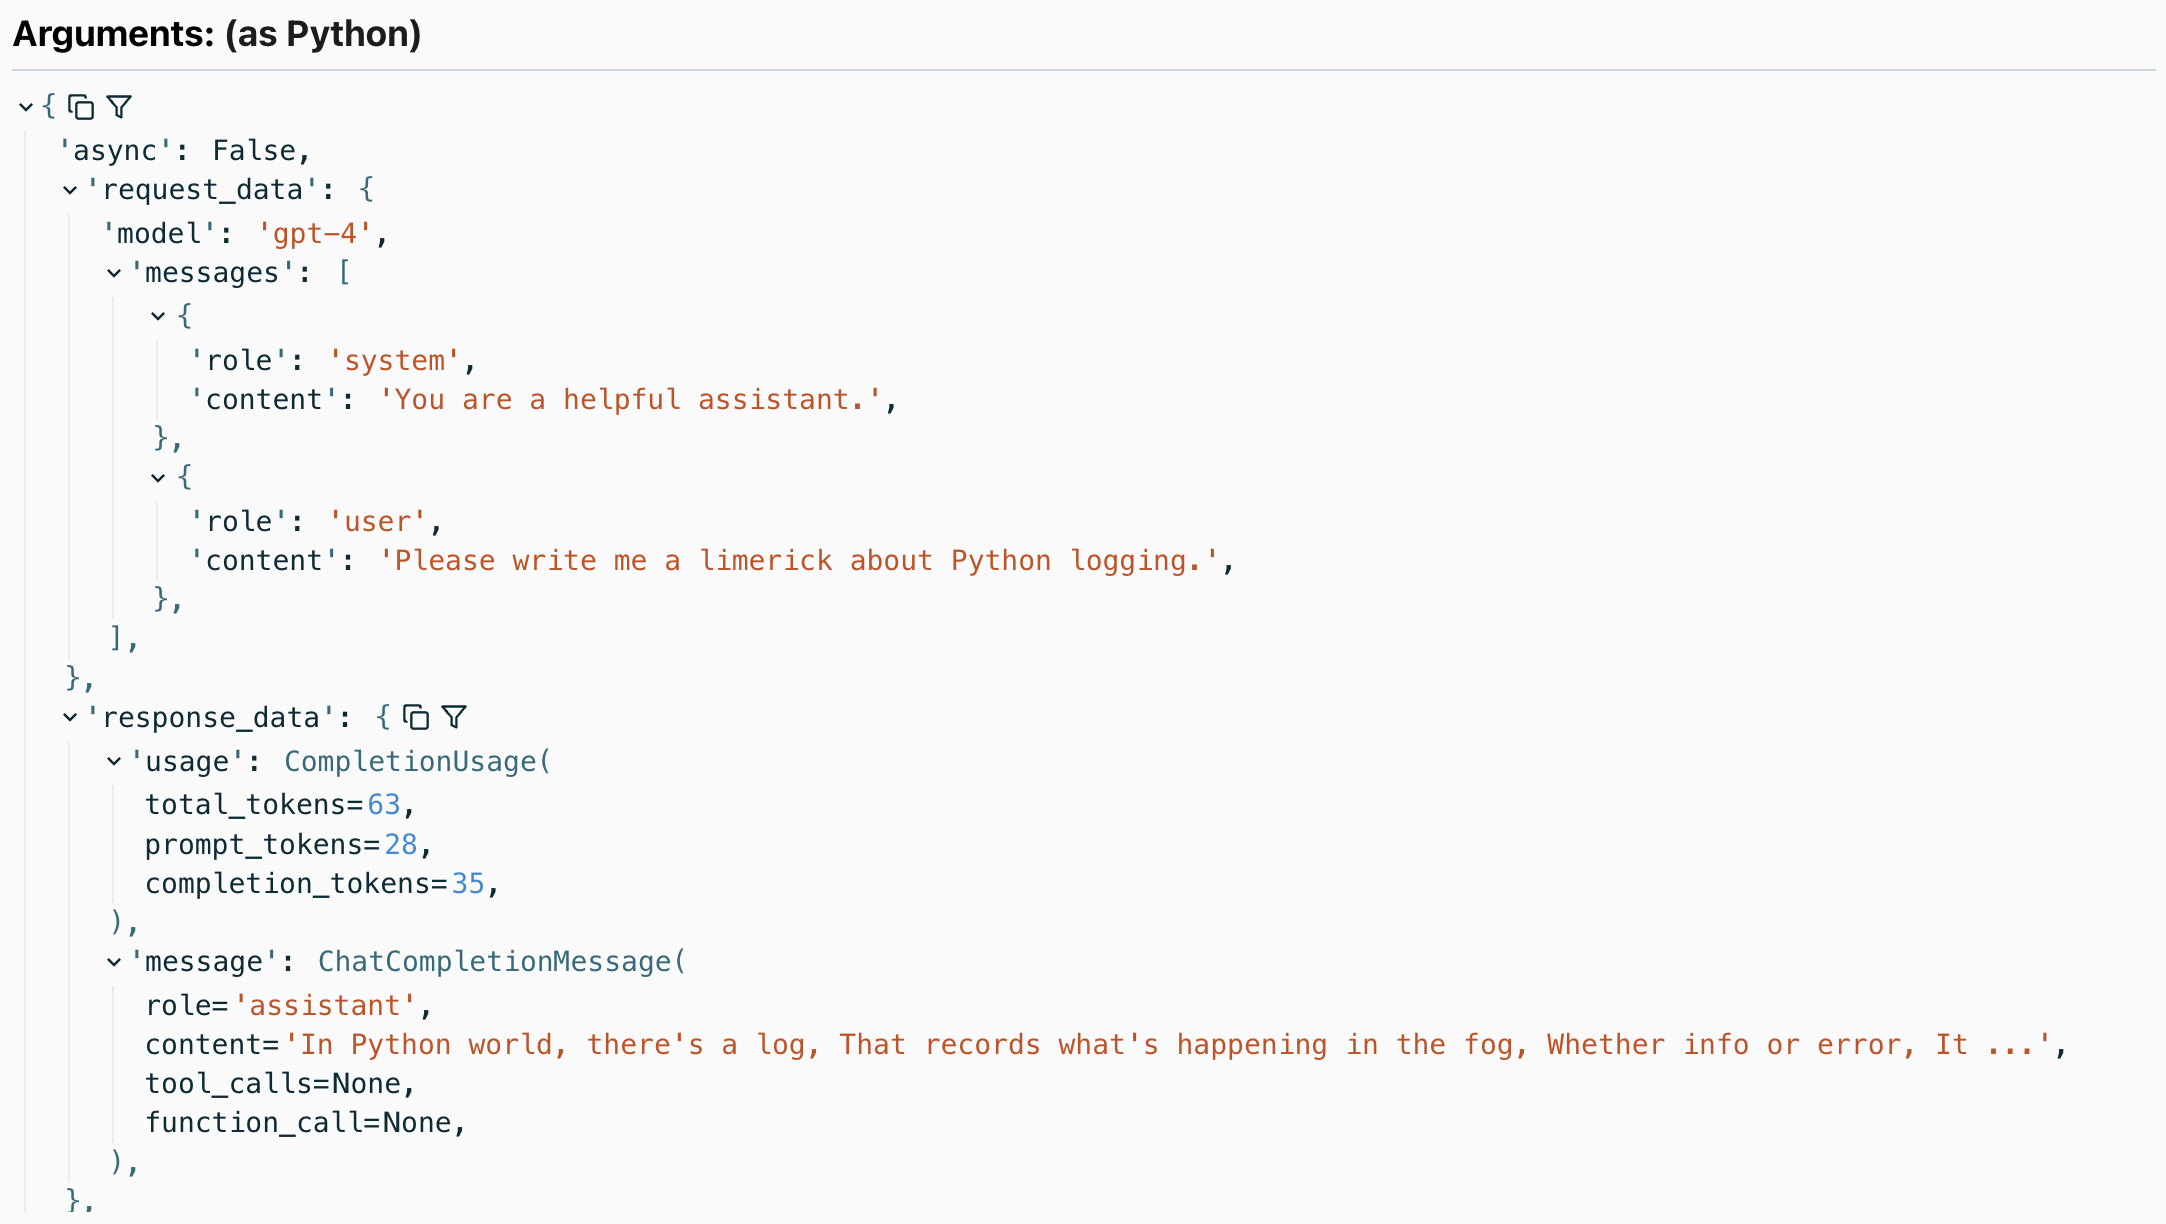
Сведения о ответе, включая количество использованных токенов
Охватываемые методологии
Включает следующие методы OpenAI:
-
client.chat.completions.create- Есть и нет.stream=True -
client.completions.create- Есть и нет.stream=True client.embeddings.createclient.images.generate
Все методы содержатся в openai 中。客户端 и openai。AsyncClient.
Например, следующее определение вызова создания изображения:
import openai
import logfire

async def main():
    client = openai.AsyncClient()
    logfire.configure()
    logfire.instrument_openai(client)

    response = await client.images.generate(
        prompt='Image of R2D2 running through a desert in the style of cyberpunk.',
        model='dall-e-3',
    )
    url = response.data[0].url
    import webbrowser
    webbrowser.open(url)

if __name__ == '__main__':
    import asyncio
    asyncio.run(main())
Для:
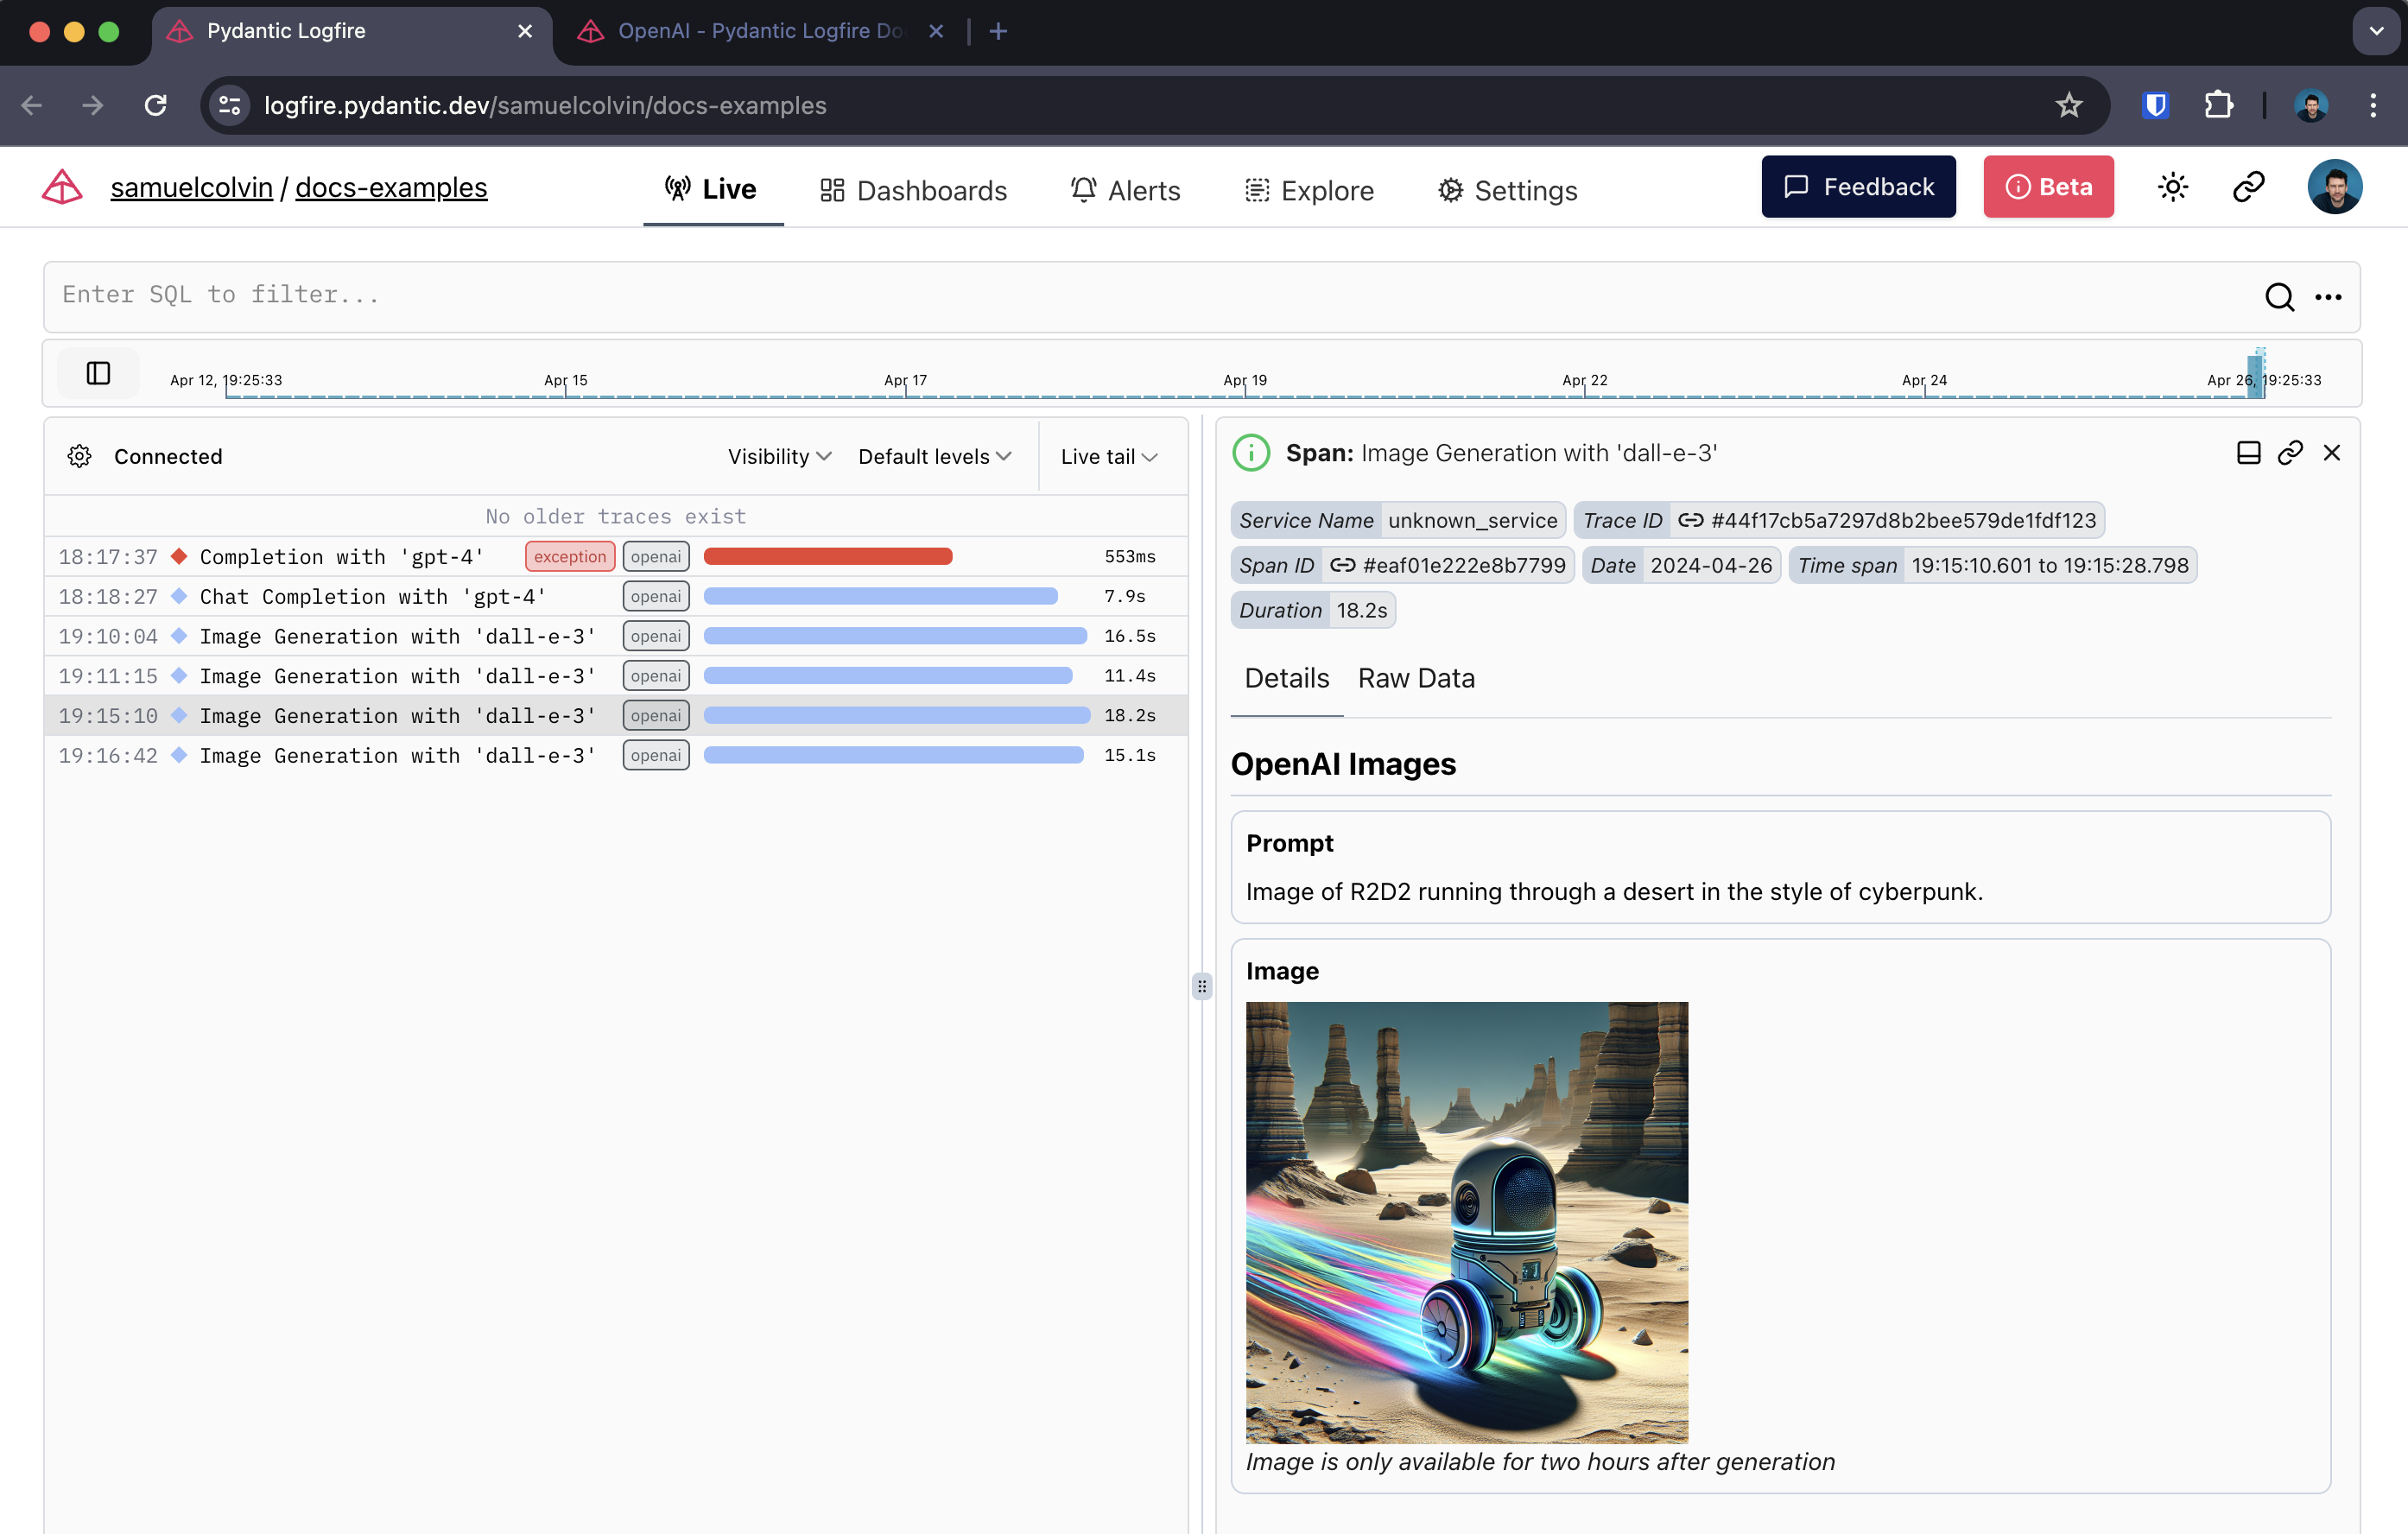
OpenAI создает диапазон изображений
Потоковая реакция
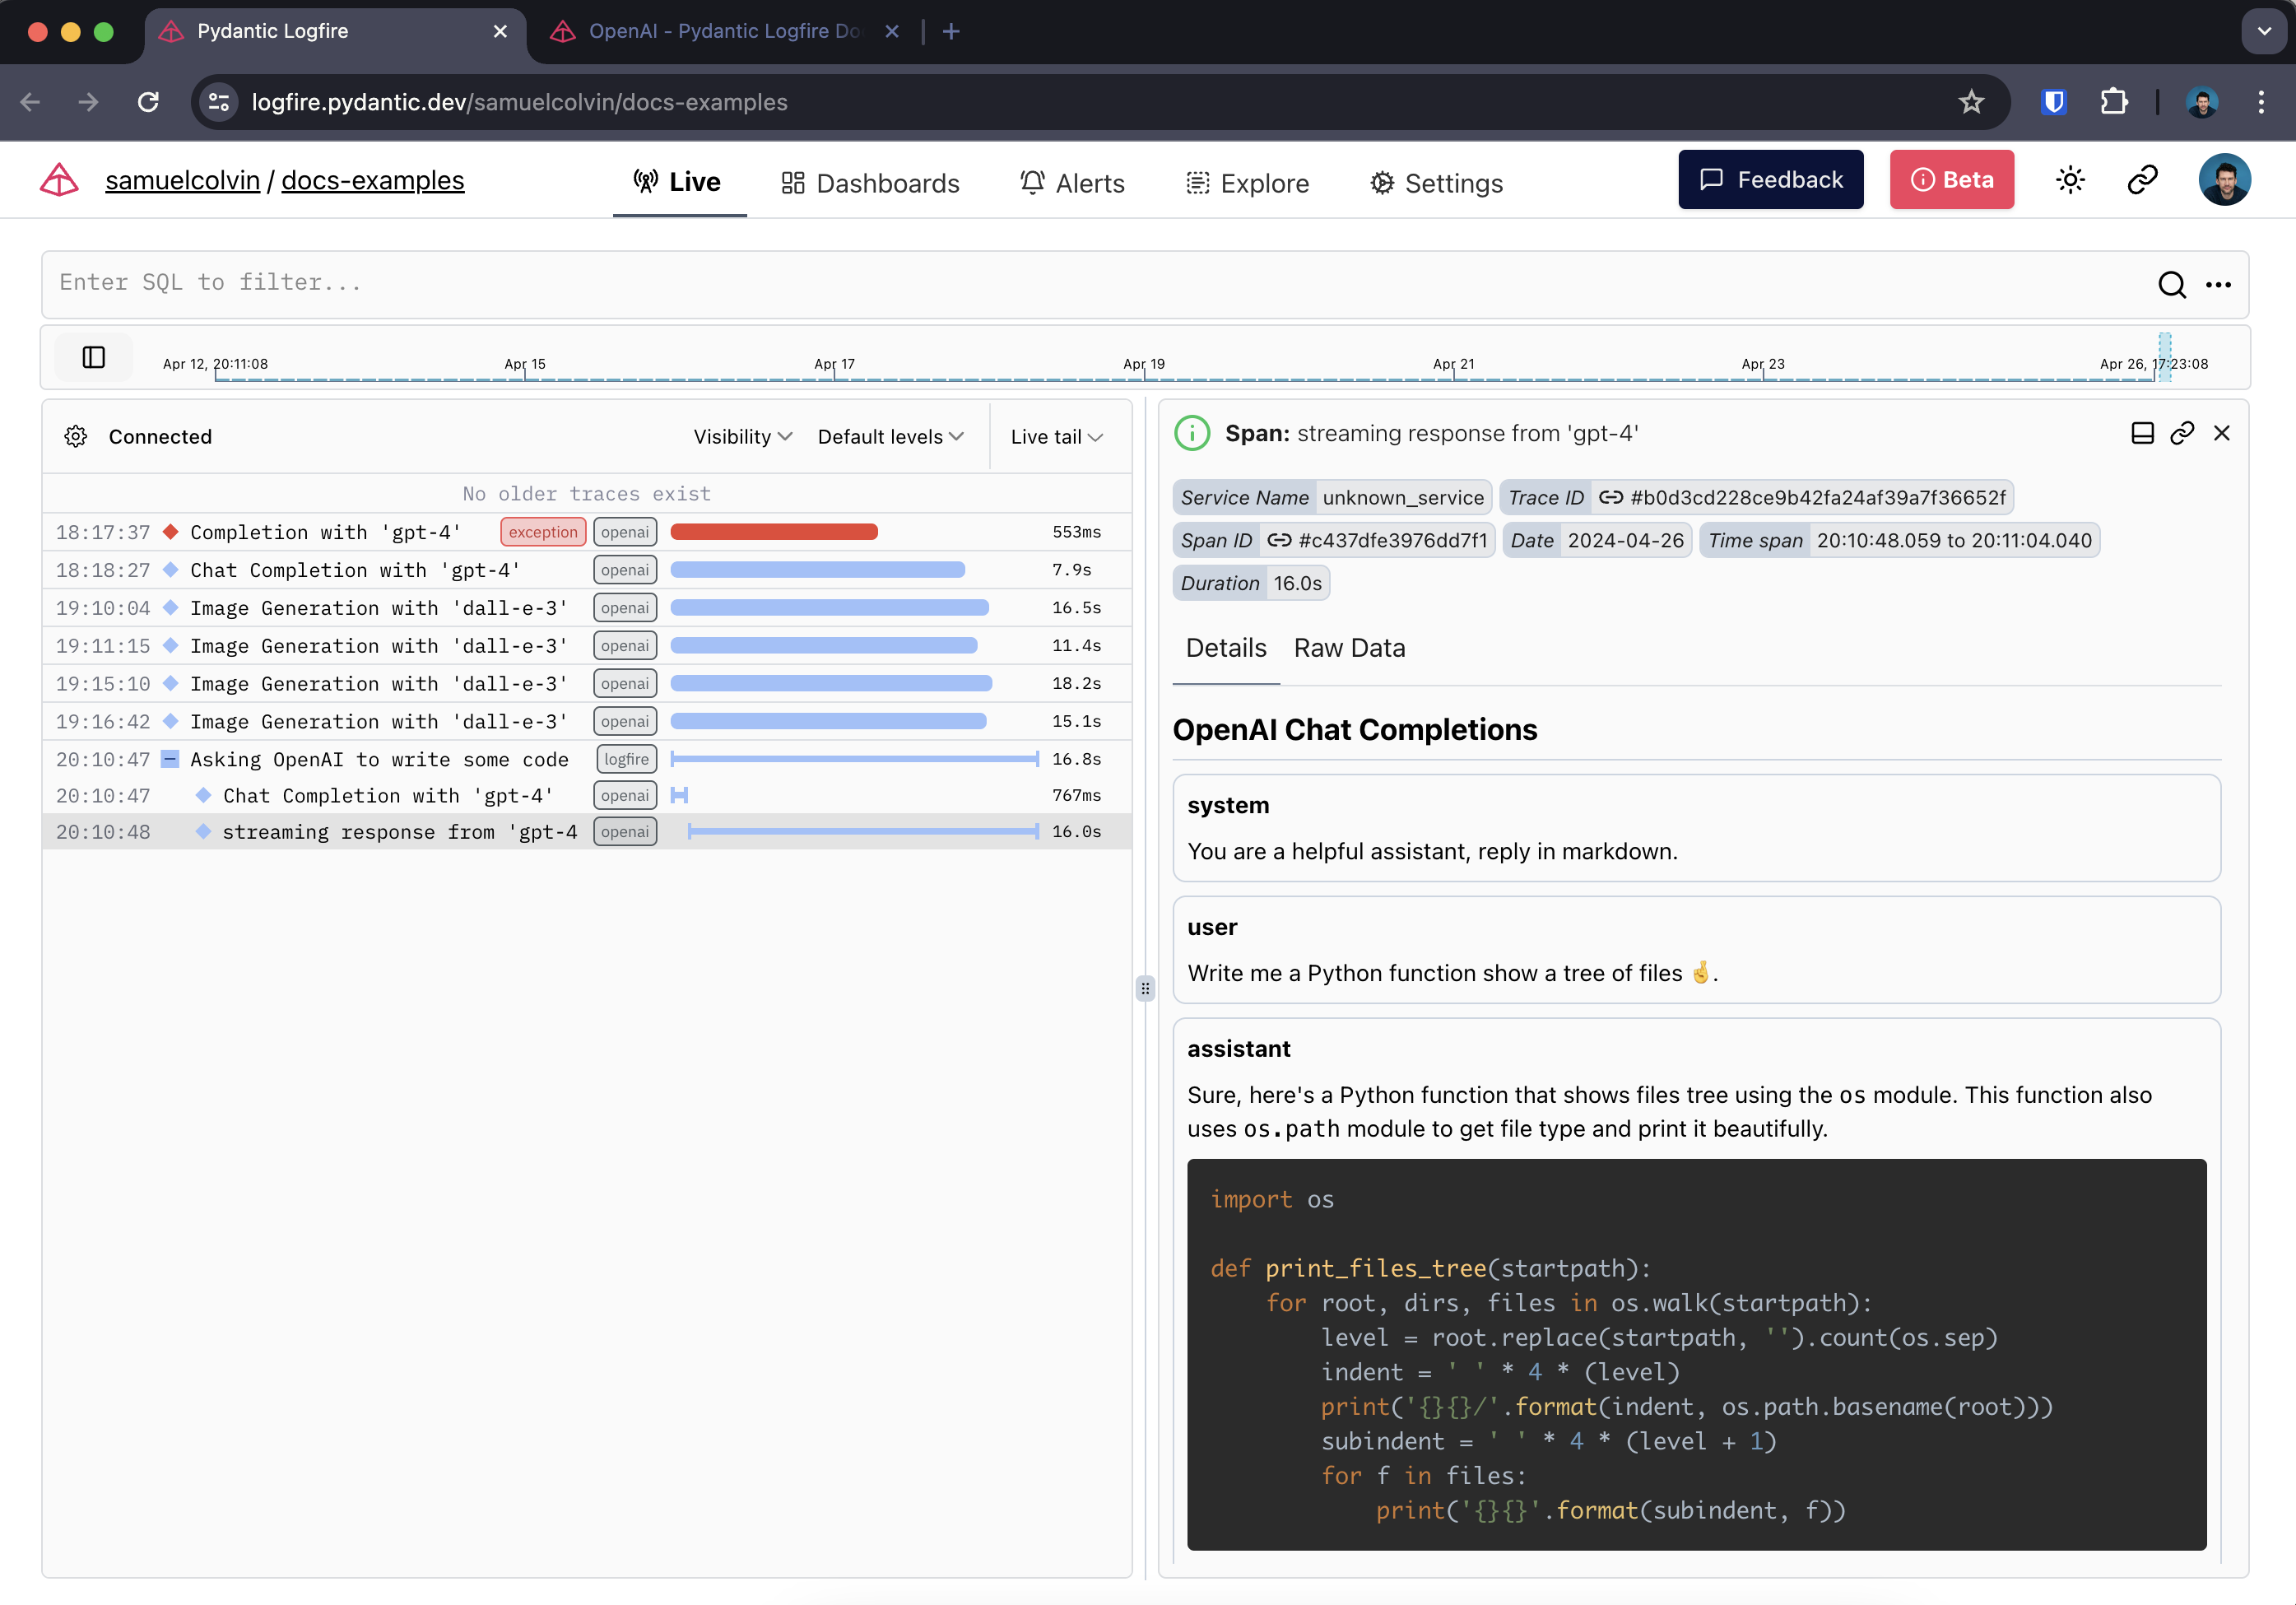
При обнаружении потокового ответа Logfire создает два диапазона: один вокруг первоначального запроса, а другой-вокруг потокового ответа.
И здесь мы используем Rich. Live и Markdown Тип рендеринга ответов в реальном времени в терминале.: Танцовщица:
import openai
import logfire
from rich.console import Console
from rich.live import Live
from rich.markdown import Markdown

client = openai.AsyncClient()
logfire.configure()
logfire.instrument_openai(client)

async def main():
    console = Console()
    with logfire.span('Asking OpenAI to write some code'):
        response = await client.chat.completions.create(
            model='gpt-4',
            messages=[
                {'role': 'system', 'content': 'Reply in markdown one.'},
                {'role': 'user', 'content': 'Write Python to show a tree of files 🤞.'},
            ],
            stream=True
        )
        content = ''
        with Live('', refresh_per_second=15, console=console) as live:
            async for chunk in response:
                if chunk.choices[0].delta.content is not None:
                    content += chunk.choices[0].delta.content
                    live.update(Markdown(content))

if __name__ == '__main__':
    import asyncio
    asyncio.run(main())
В Logfire это выглядит следующим образом:
本文总阅读量次