OpenAI
memperkenalkan
Logfire mendukung penggunaan baris kode tambahan untuk mendeteksi panggilan ke OpenAI.
import openai
import logfire

client = openai.Client()

logfire.configure()
logfire.instrument_openai(client)  # (1)!

response = client.chat.completions.create(
    model='gpt-4',
    messages=[
        {'role': 'system', 'content': 'You are a helpful assistant.'},
        {'role': 'user', 'content': 'Please write me a limerick about Python logging.'},
    ],
)
print(response.choices[0].message)
-
Jika Anda tidak dapat mengakses instance sisi klien, Anda dapat melewati kelas (misalnya,
logfire.instrument_openai(openai.Client)), atau tidak memberikan argumen (yaitu,logfire.instrument_openai()) untuk mendeteksi kelasopenai。客户端danopenai。AsyncClient.
_
Untuk informasi lebih lanjut, lihat [Referensi API instrument_openai()] [logfire. logfire. instrument _ openai]. _
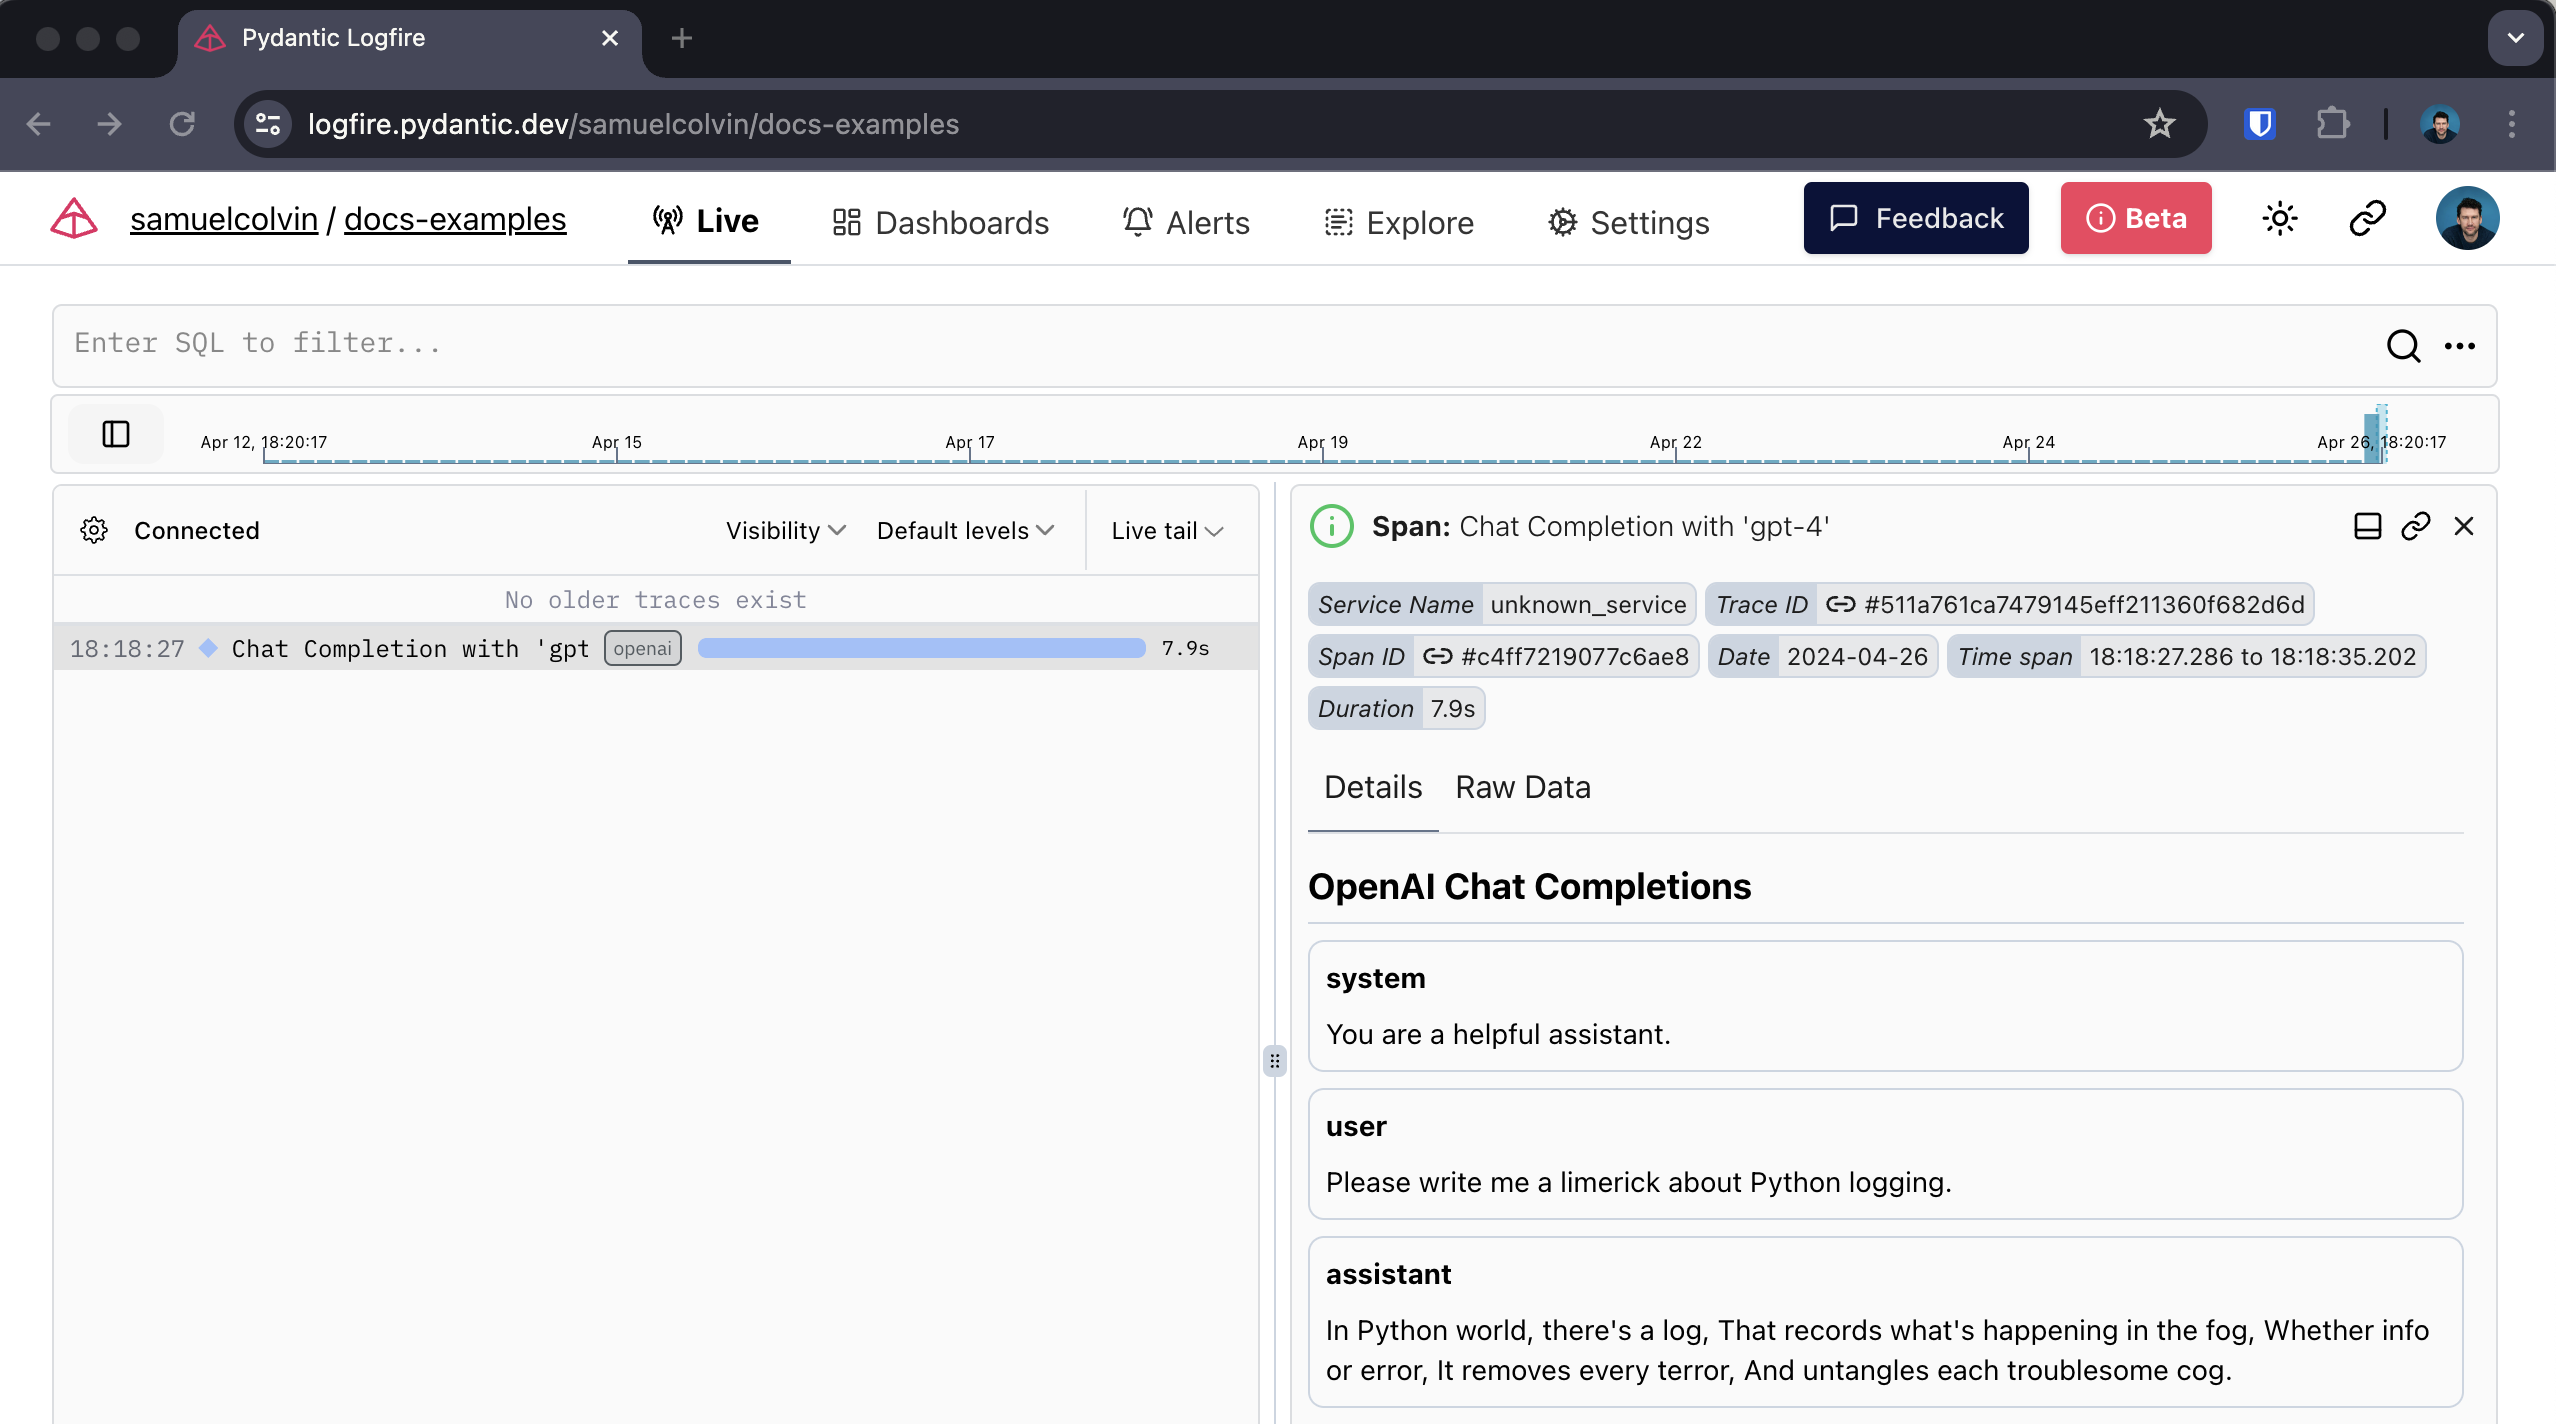
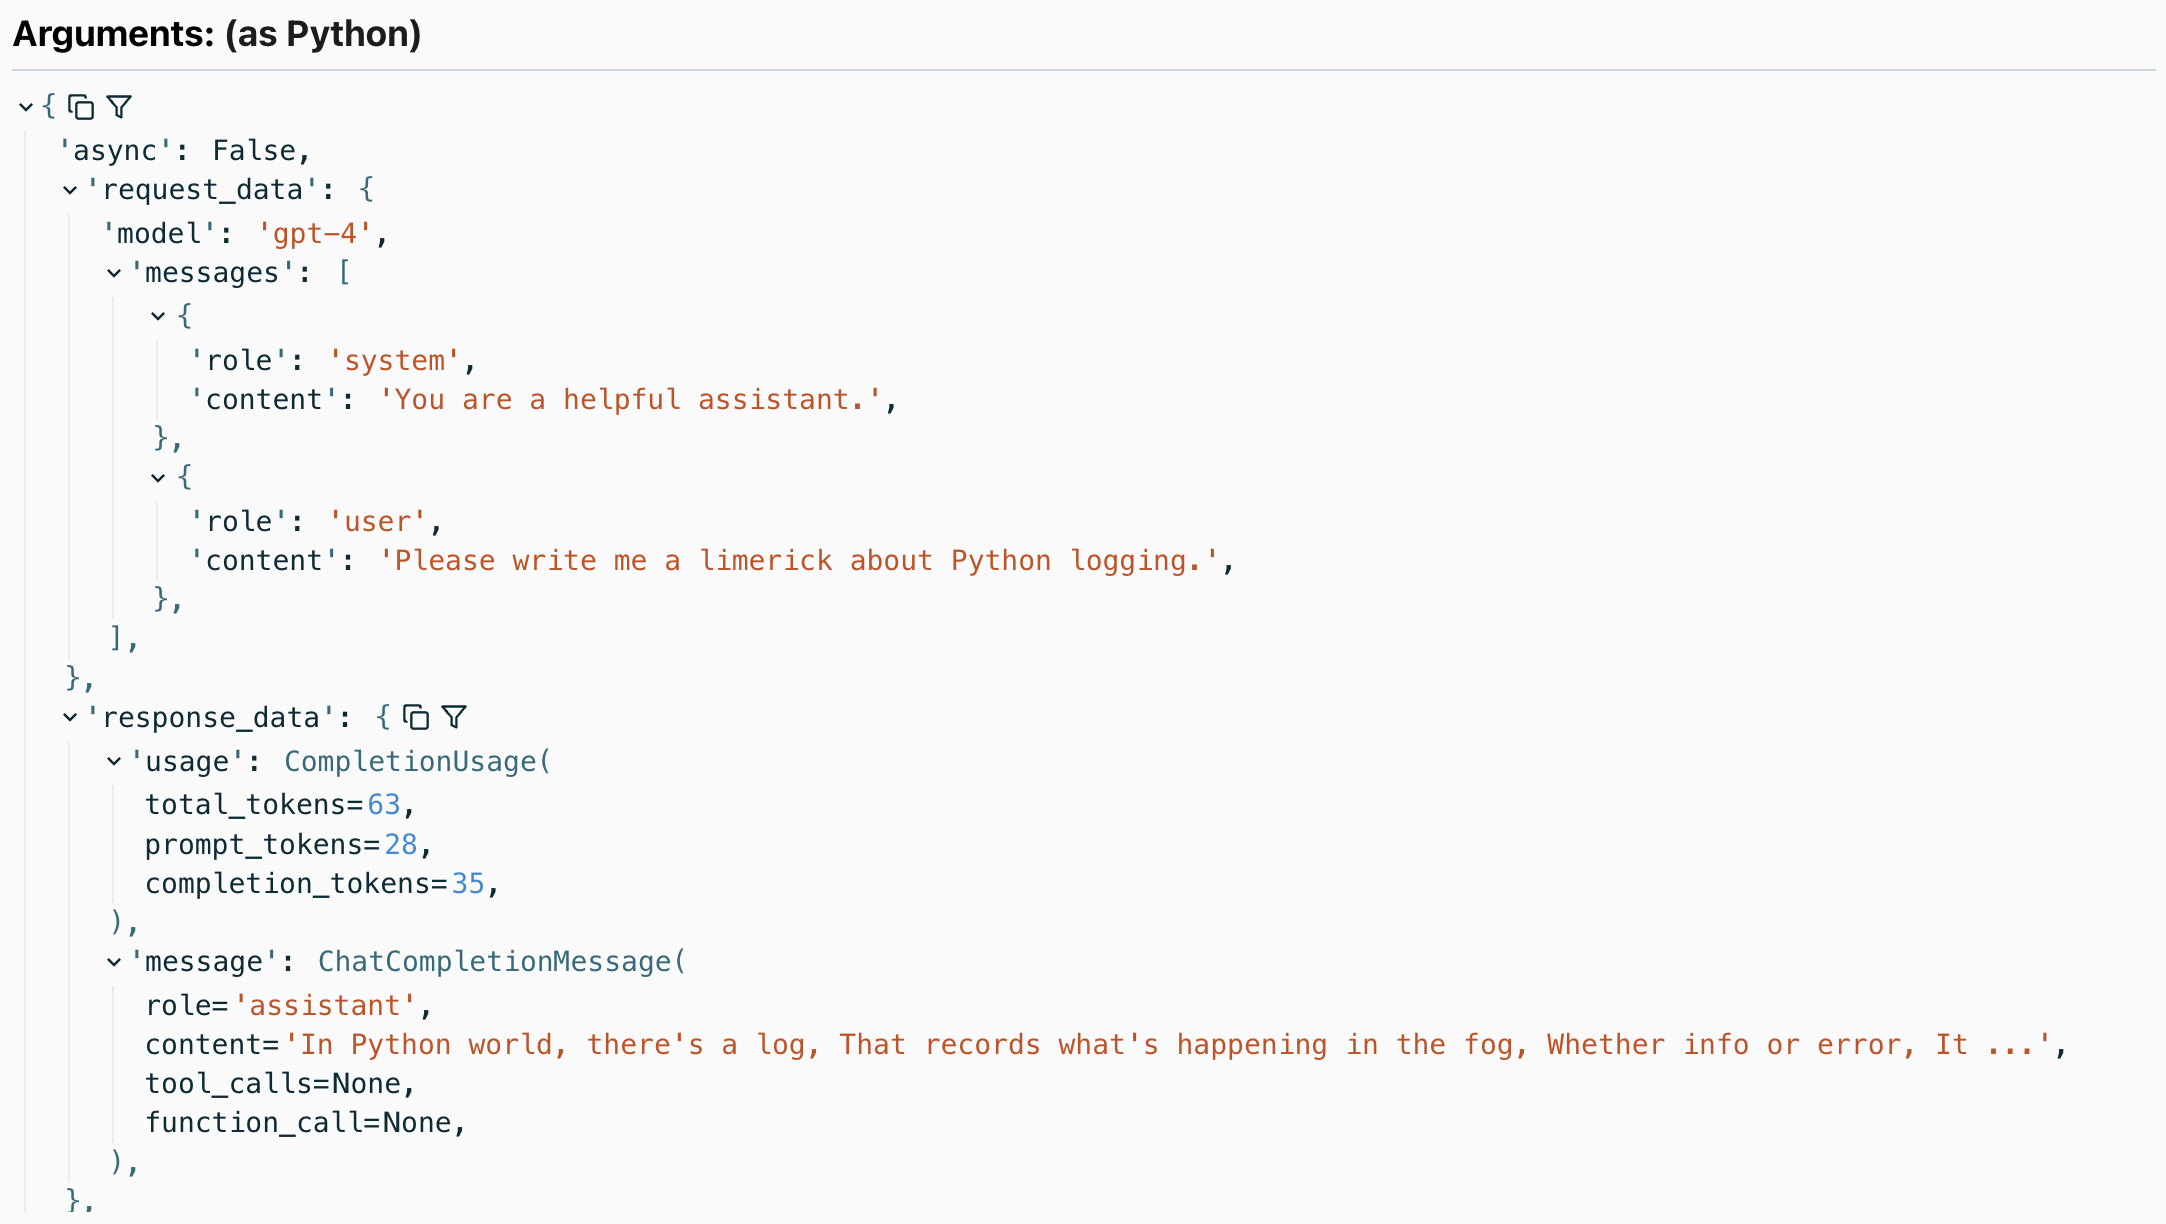
Dengan itu, Anda dapat memperoleh:
-
Rentang seputar panggilan ke OpenAI, yang mencatat durasi dan menangkap pengecualian yang mungkin terjadi
-
Tampilan percakapan yang dapat dibaca manusia dengan agen
-
Rincian tanggapan, termasuk jumlah token yang digunakan
Metode tertutup
Metode OpenAI berikut ini tercakup:
-
client.chat.completions.createIya dan tidak.stream=True -
client.completions.createIya dan tidak.stream=True client.embeddings.createclient.images.generate
Semua metode terkandung dalam openai 中。客户端 dan openai。AsyncClient.
Misalnya, berikut adalah deteksi panggilan generasi gambar:
import openai
import logfire

async def main():
    client = openai.AsyncClient()
    logfire.configure()
    logfire.instrument_openai(client)

    response = await client.images.generate(
        prompt='Image of R2D2 running through a desert in the style of cyberpunk.',
        model='dall-e-3',
    )
    url = response.data[0].url
    import webbrowser
    webbrowser.open(url)

if __name__ == '__main__':
    import asyncio
    asyncio.run(main())
Memberi:
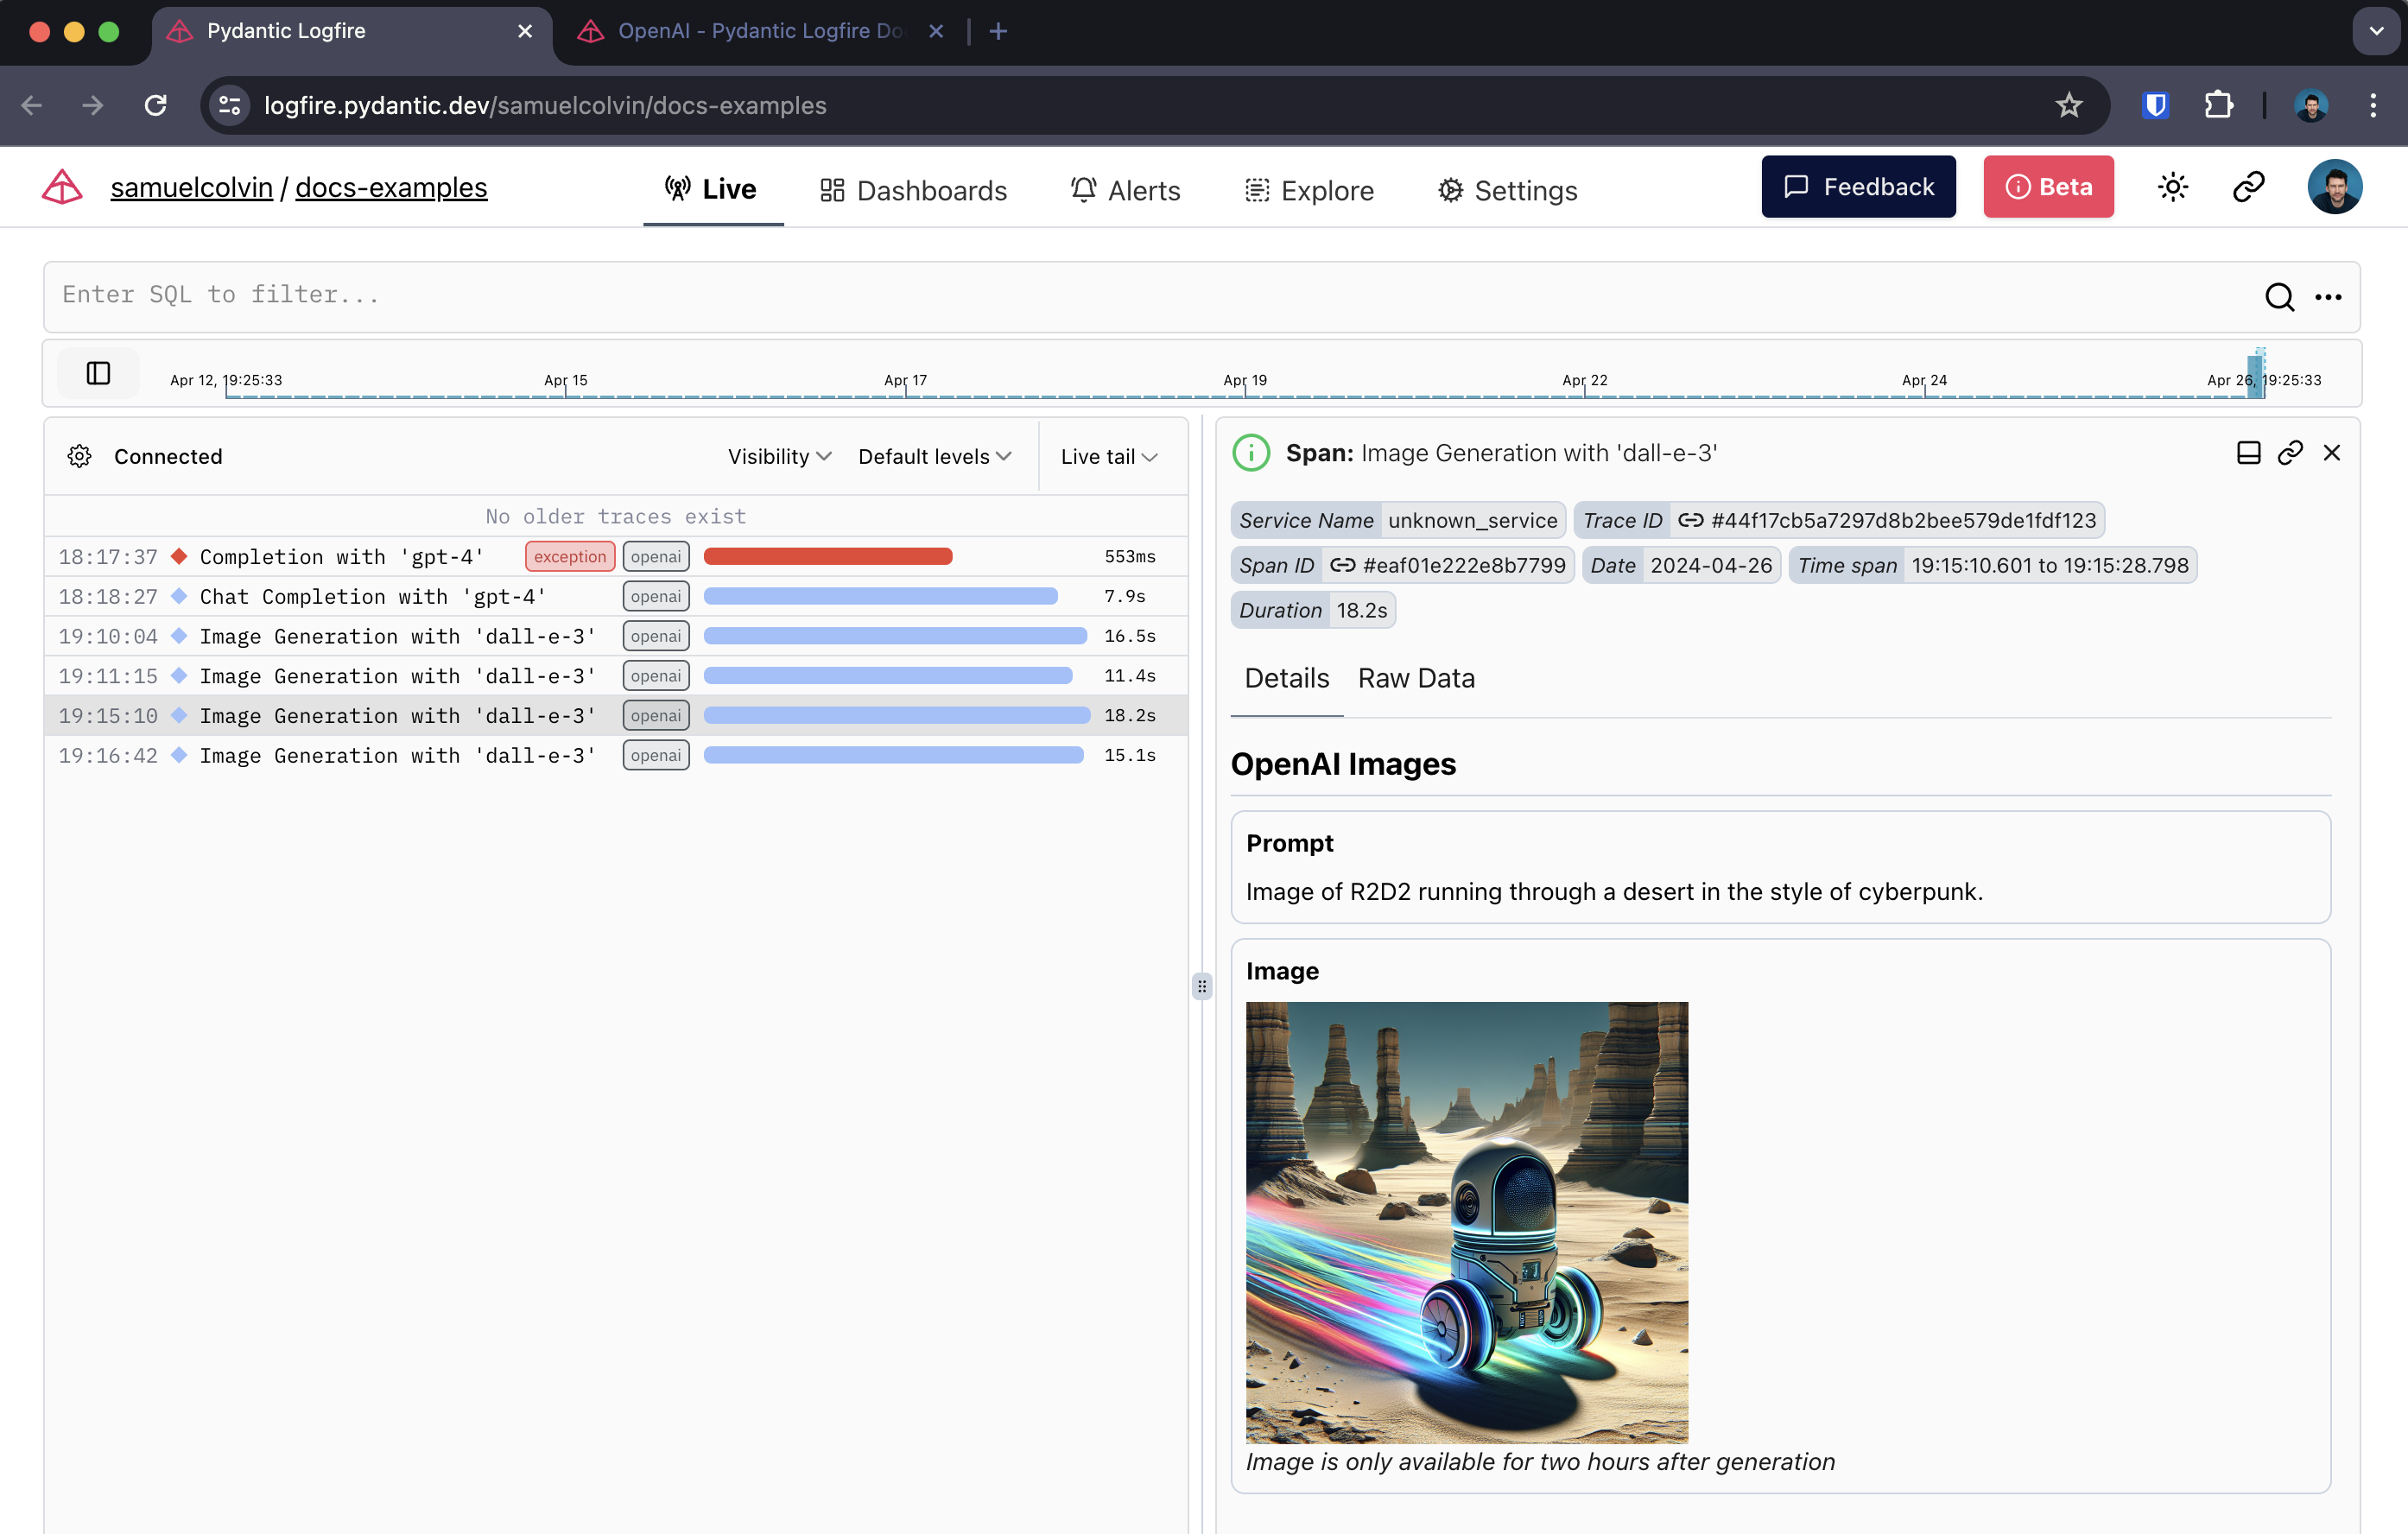
Rentang pembuatan gambar OpenAI
respons streaming
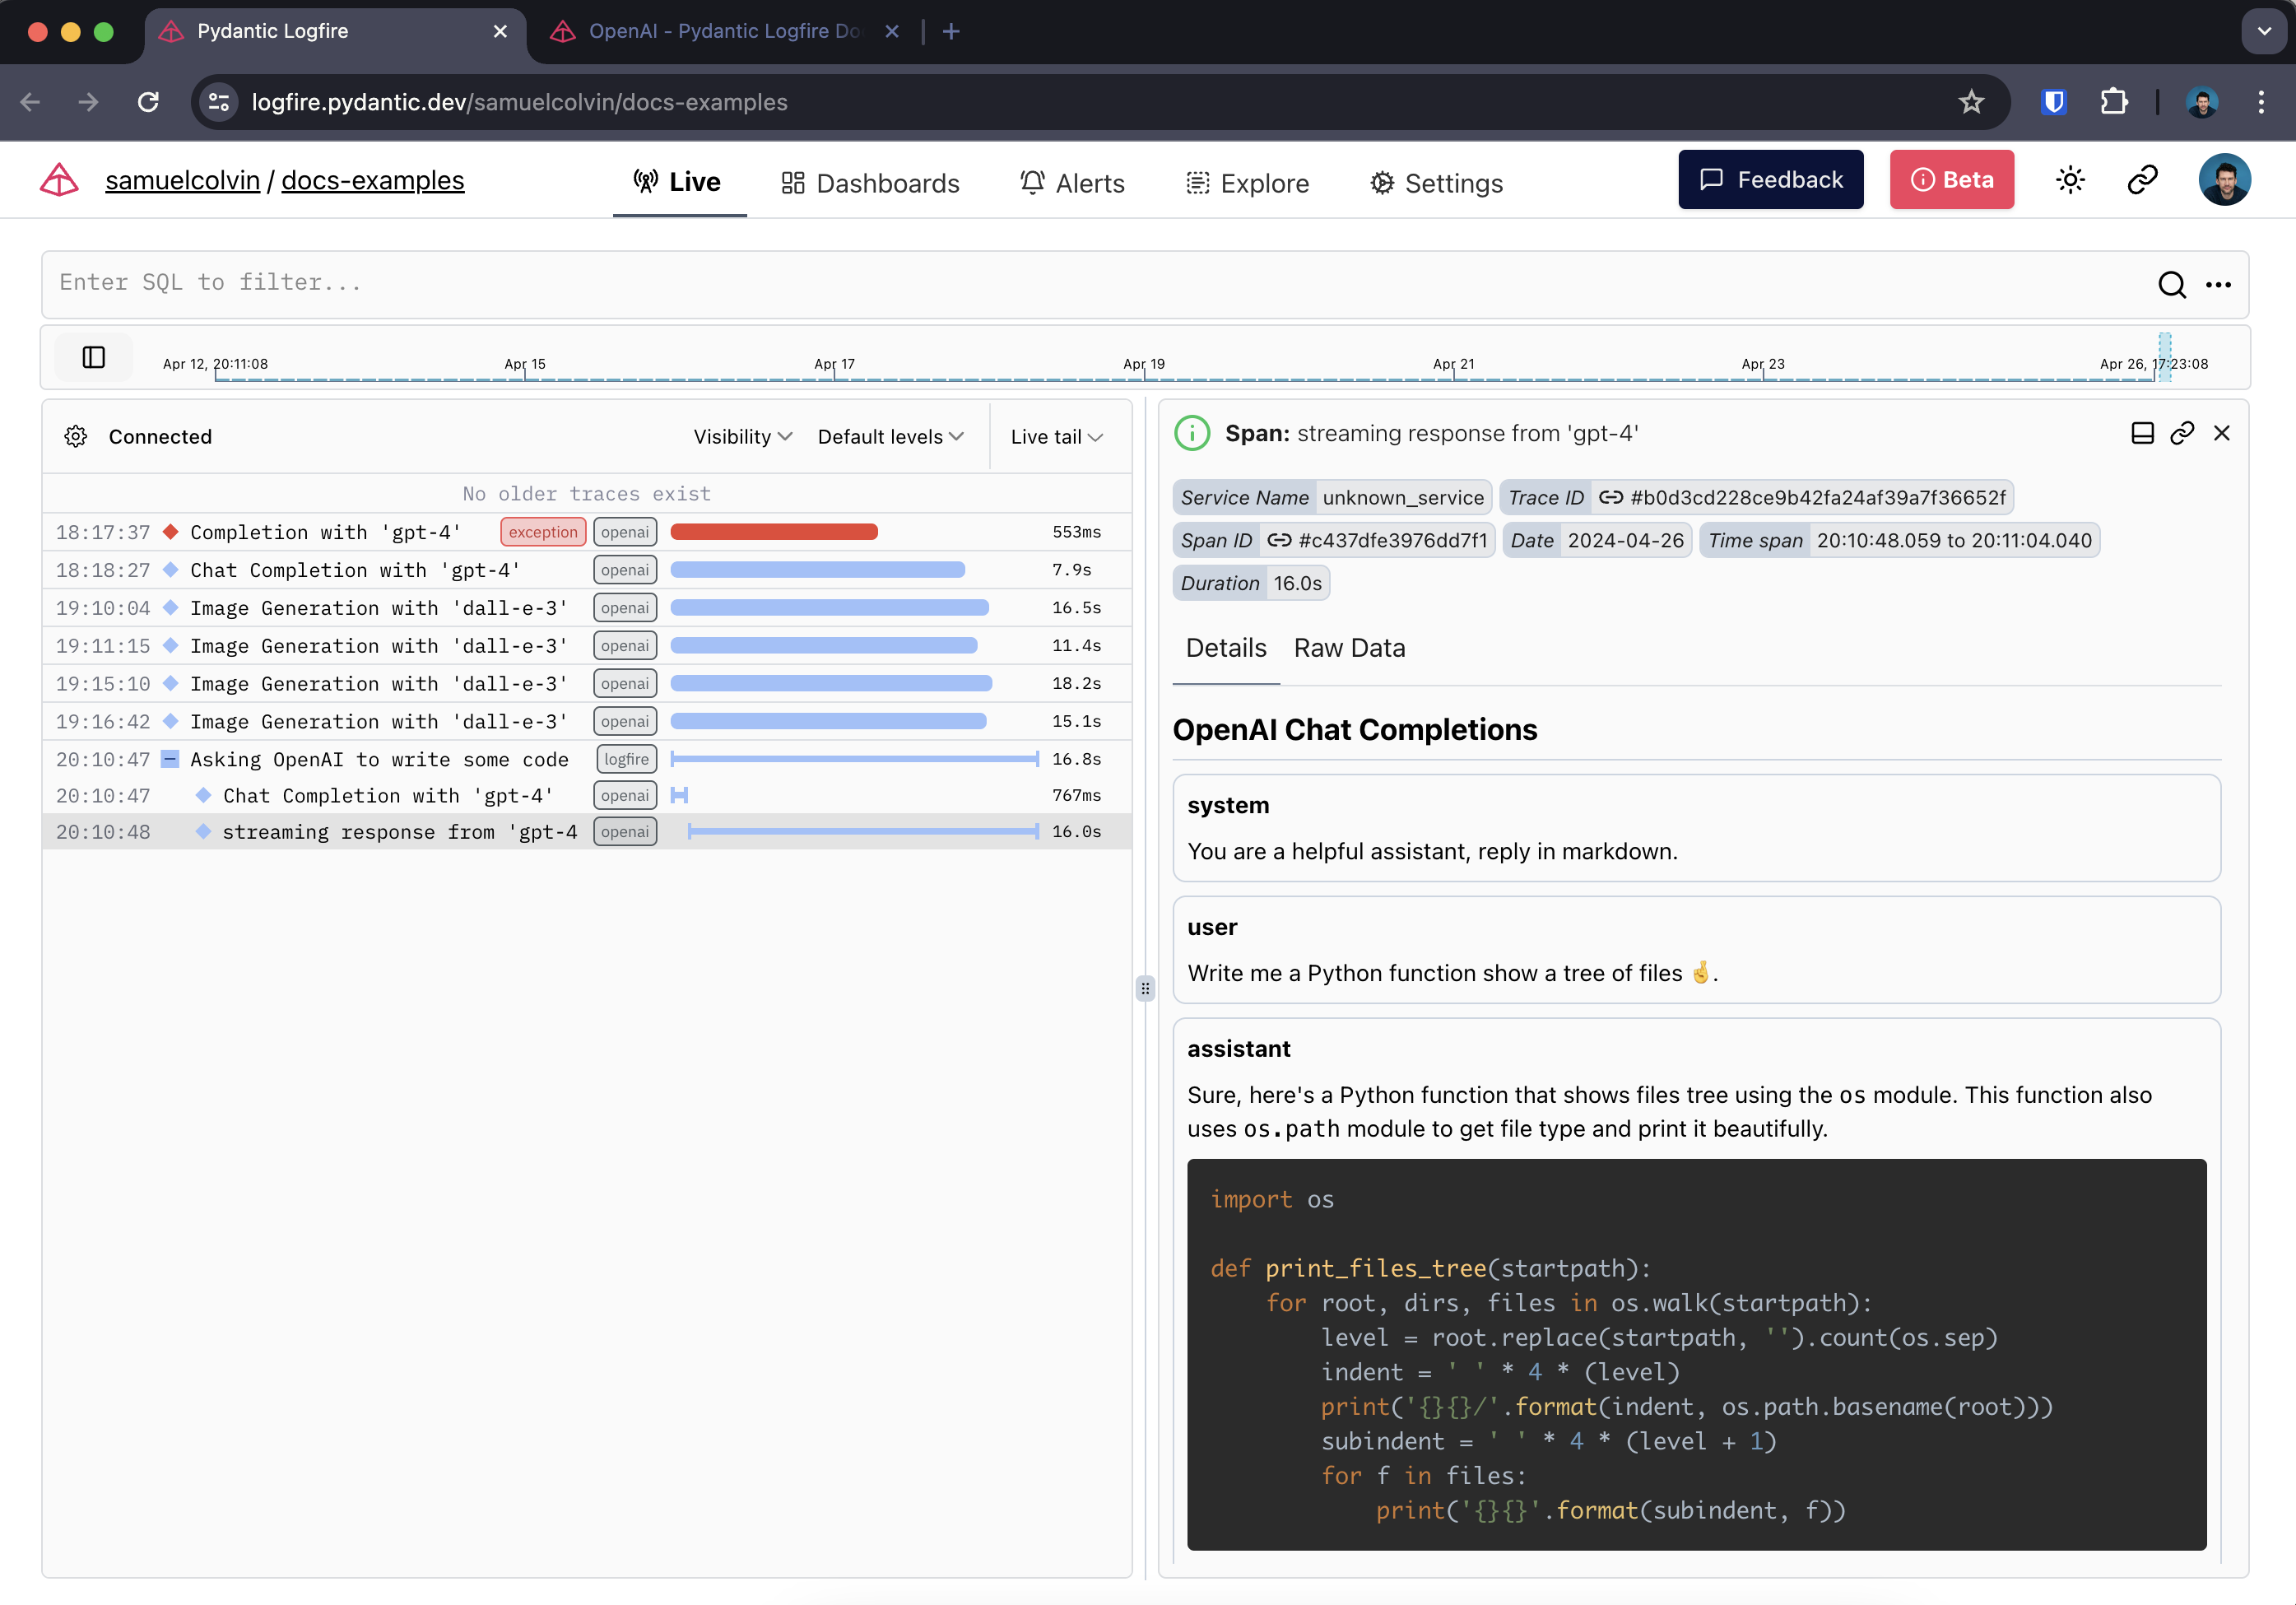
Saat mendeteksi respons streaming, Logfire membuat dua bentang - satu di sekitar permintaan awal dan satu di sekitar respons streaming.
Di sini, kami juga menggunakan Rich 's Live dan Markdown Tipe memberikan respons secara real time di titik akhir.
import openai
import logfire
from rich.console import Console
from rich.live import Live
from rich.markdown import Markdown

client = openai.AsyncClient()
logfire.configure()
logfire.instrument_openai(client)

async def main():
    console = Console()
    with logfire.span('Asking OpenAI to write some code'):
        response = await client.chat.completions.create(
            model='gpt-4',
            messages=[
                {'role': 'system', 'content': 'Reply in markdown one.'},
                {'role': 'user', 'content': 'Write Python to show a tree of files 🤞.'},
            ],
            stream=True
        )
        content = ''
        with Live('', refresh_per_second=15, console=console) as live:
            async for chunk in response:
                if chunk.choices[0].delta.content is not None:
                    content += chunk.choices[0].delta.content
                    live.update(Markdown(content))

if __name__ == '__main__':
    import asyncio
    asyncio.run(main())
Di Logfire, tampilannya seperti ini:
本文总阅读量次