OpenAI
introduceren
Logfire ondersteunt het gebruik van een extra regel code om oproepen naar OpenAI te detecteren.
import openai
import logfire

client = openai.Client()

logfire.configure()
logfire.instrument_openai(client)  # (1)!

response = client.chat.completions.create(
    model='gpt-4',
    messages=[
        {'role': 'system', 'content': 'You are a helpful assistant.'},
        {'role': 'user', 'content': 'Please write me a limerick about Python logging.'},
    ],
)
print(response.choices[0].message)
-
Als u geen toegang heeft tot de client-side instantie, kunt u een klasse (bijv.
logfire.instrument_openai(openai.Client)) doorgeven of geen argumenten (bijv.logfire.instrument_openai()) doorgeven om de klassenopenai。客户端enopenai。AsyncClientte detecteren.
_
Voor meer informatie, zie [instrument_openai() API Reference] [logfire. logfire. instrument _ openai]. _
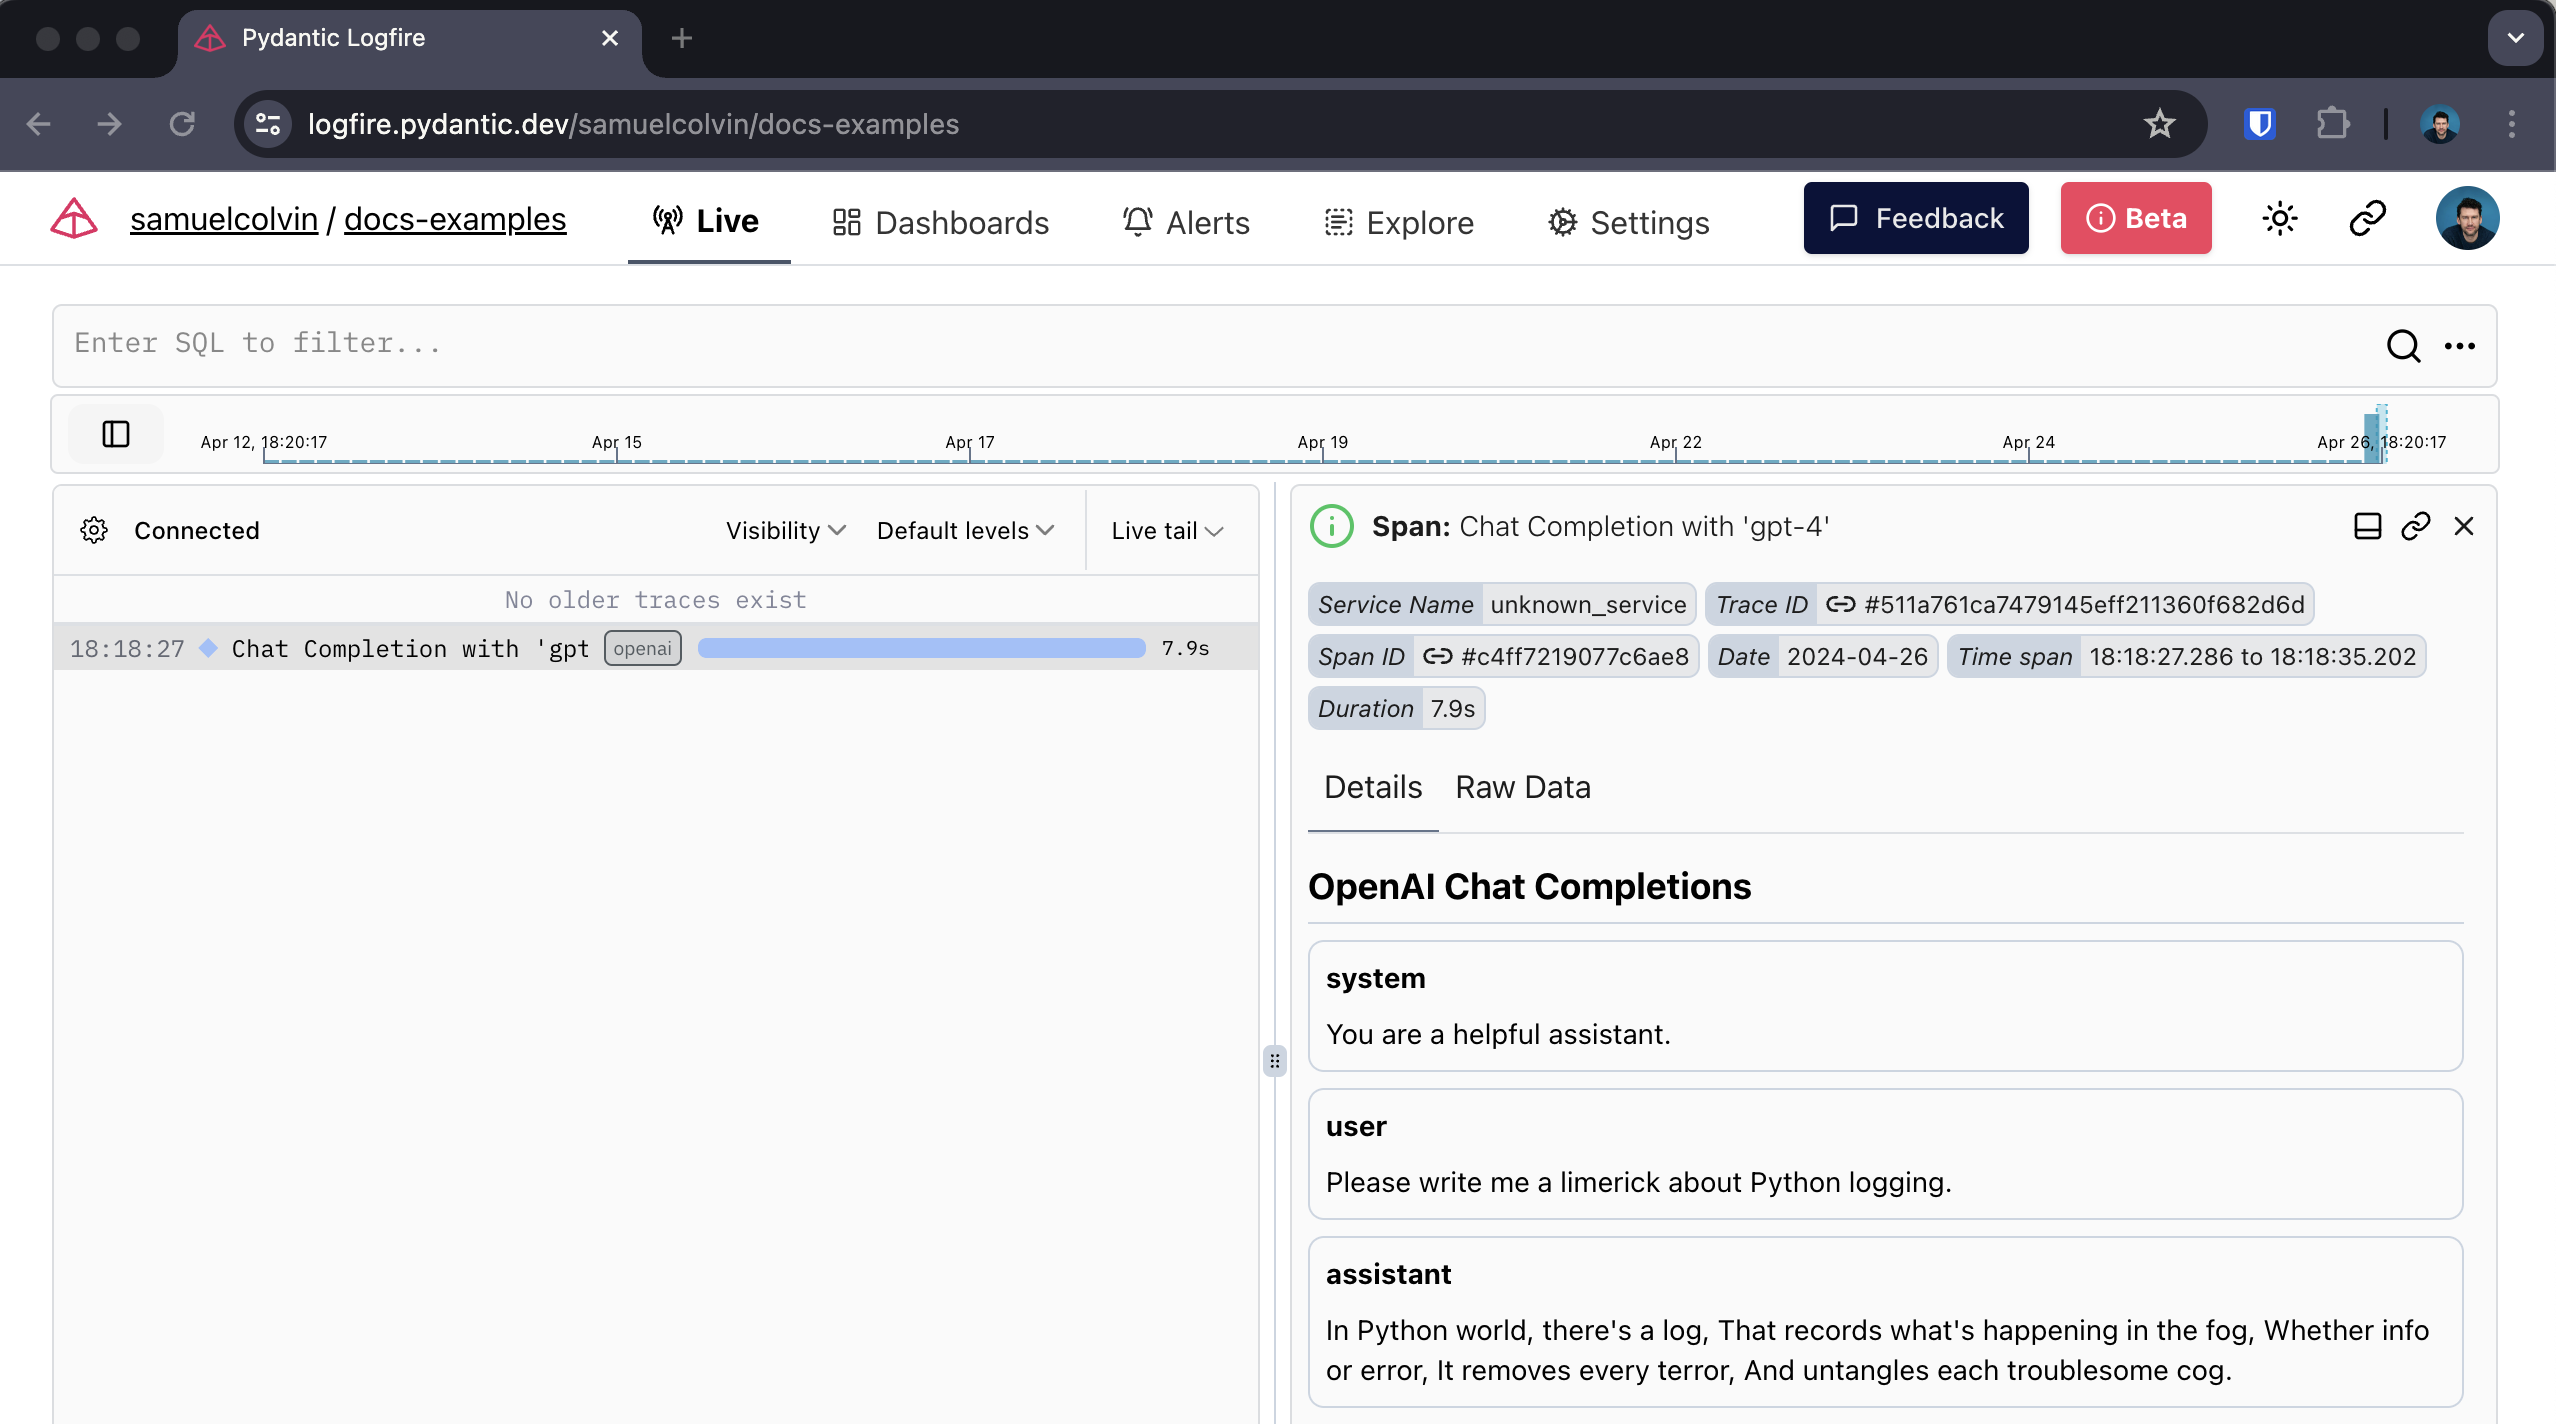
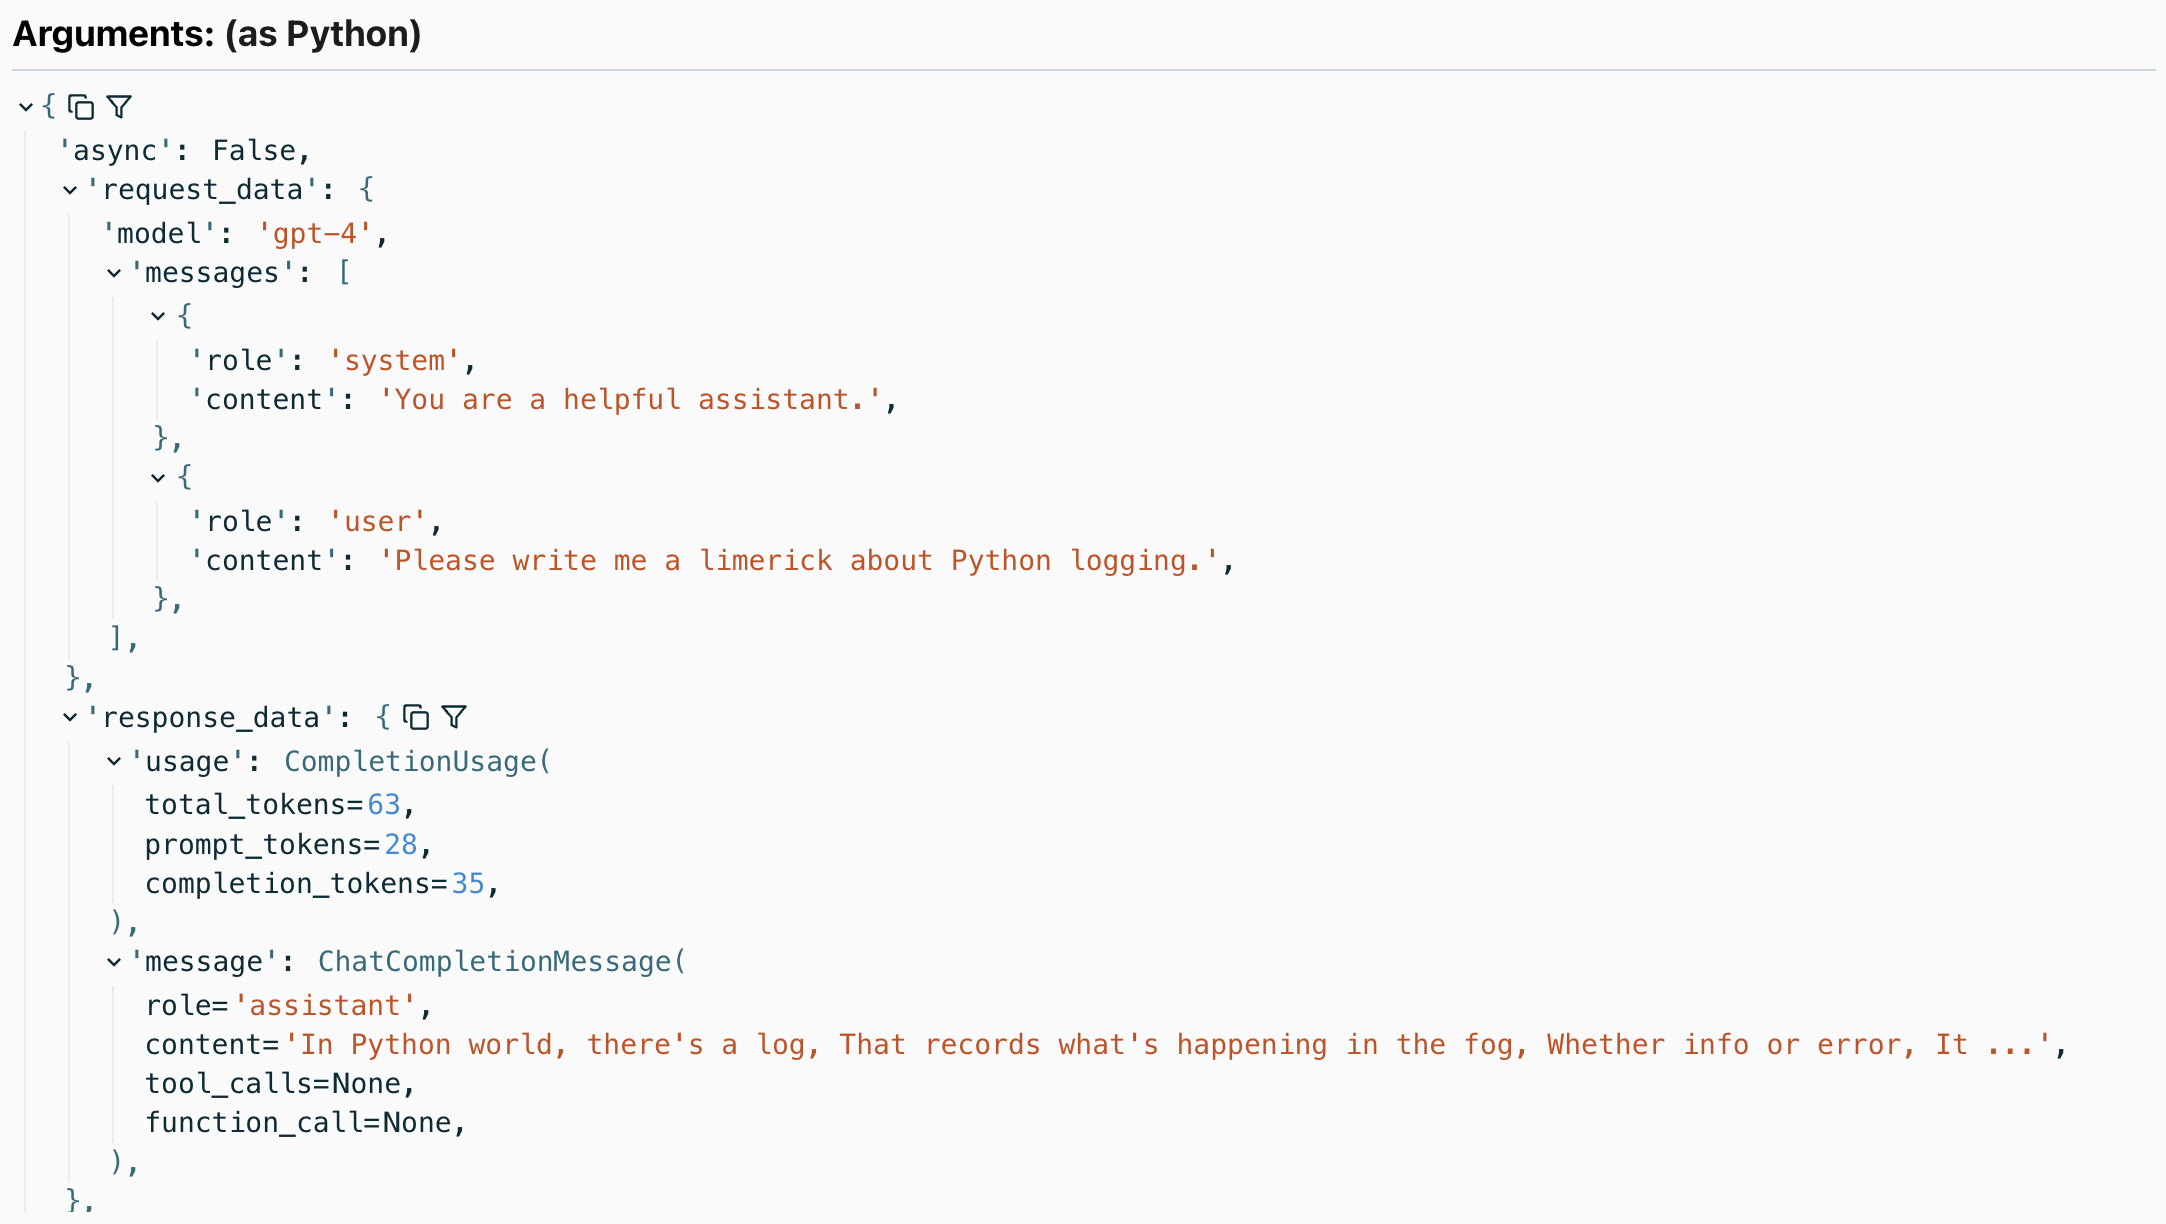
Hiermee kunt u verkrijgen:
-
De overspanning rond de oproep naar OpenAI, die de duur registreert en eventuele uitzonderingen opvangt
-
Menselijk leesbare weergave van gesprekken met agenten
-
Details van de reactie, inclusief het aantal gebruikte tokens
Behandelde methoden
De volgende OpenAI methodes komen aan bod:
-
client.chat.completions.createJa en nee.stream=True -
client.completions.createJa en nee.stream=True client.embeddings.createclient.images.generate
Alle methoden zijn opgenomen in openai 中。客户端 en openai。AsyncClient.
Hier is bijvoorbeeld de detectie van de oproep voor het genereren van afbeeldingen:
import openai
import logfire

async def main():
    client = openai.AsyncClient()
    logfire.configure()
    logfire.instrument_openai(client)

    response = await client.images.generate(
        prompt='Image of R2D2 running through a desert in the style of cyberpunk.',
        model='dall-e-3',
    )
    url = response.data[0].url
    import webbrowser
    webbrowser.open(url)

if __name__ == '__main__':
    import asyncio
    asyncio.run(main())
Geef:
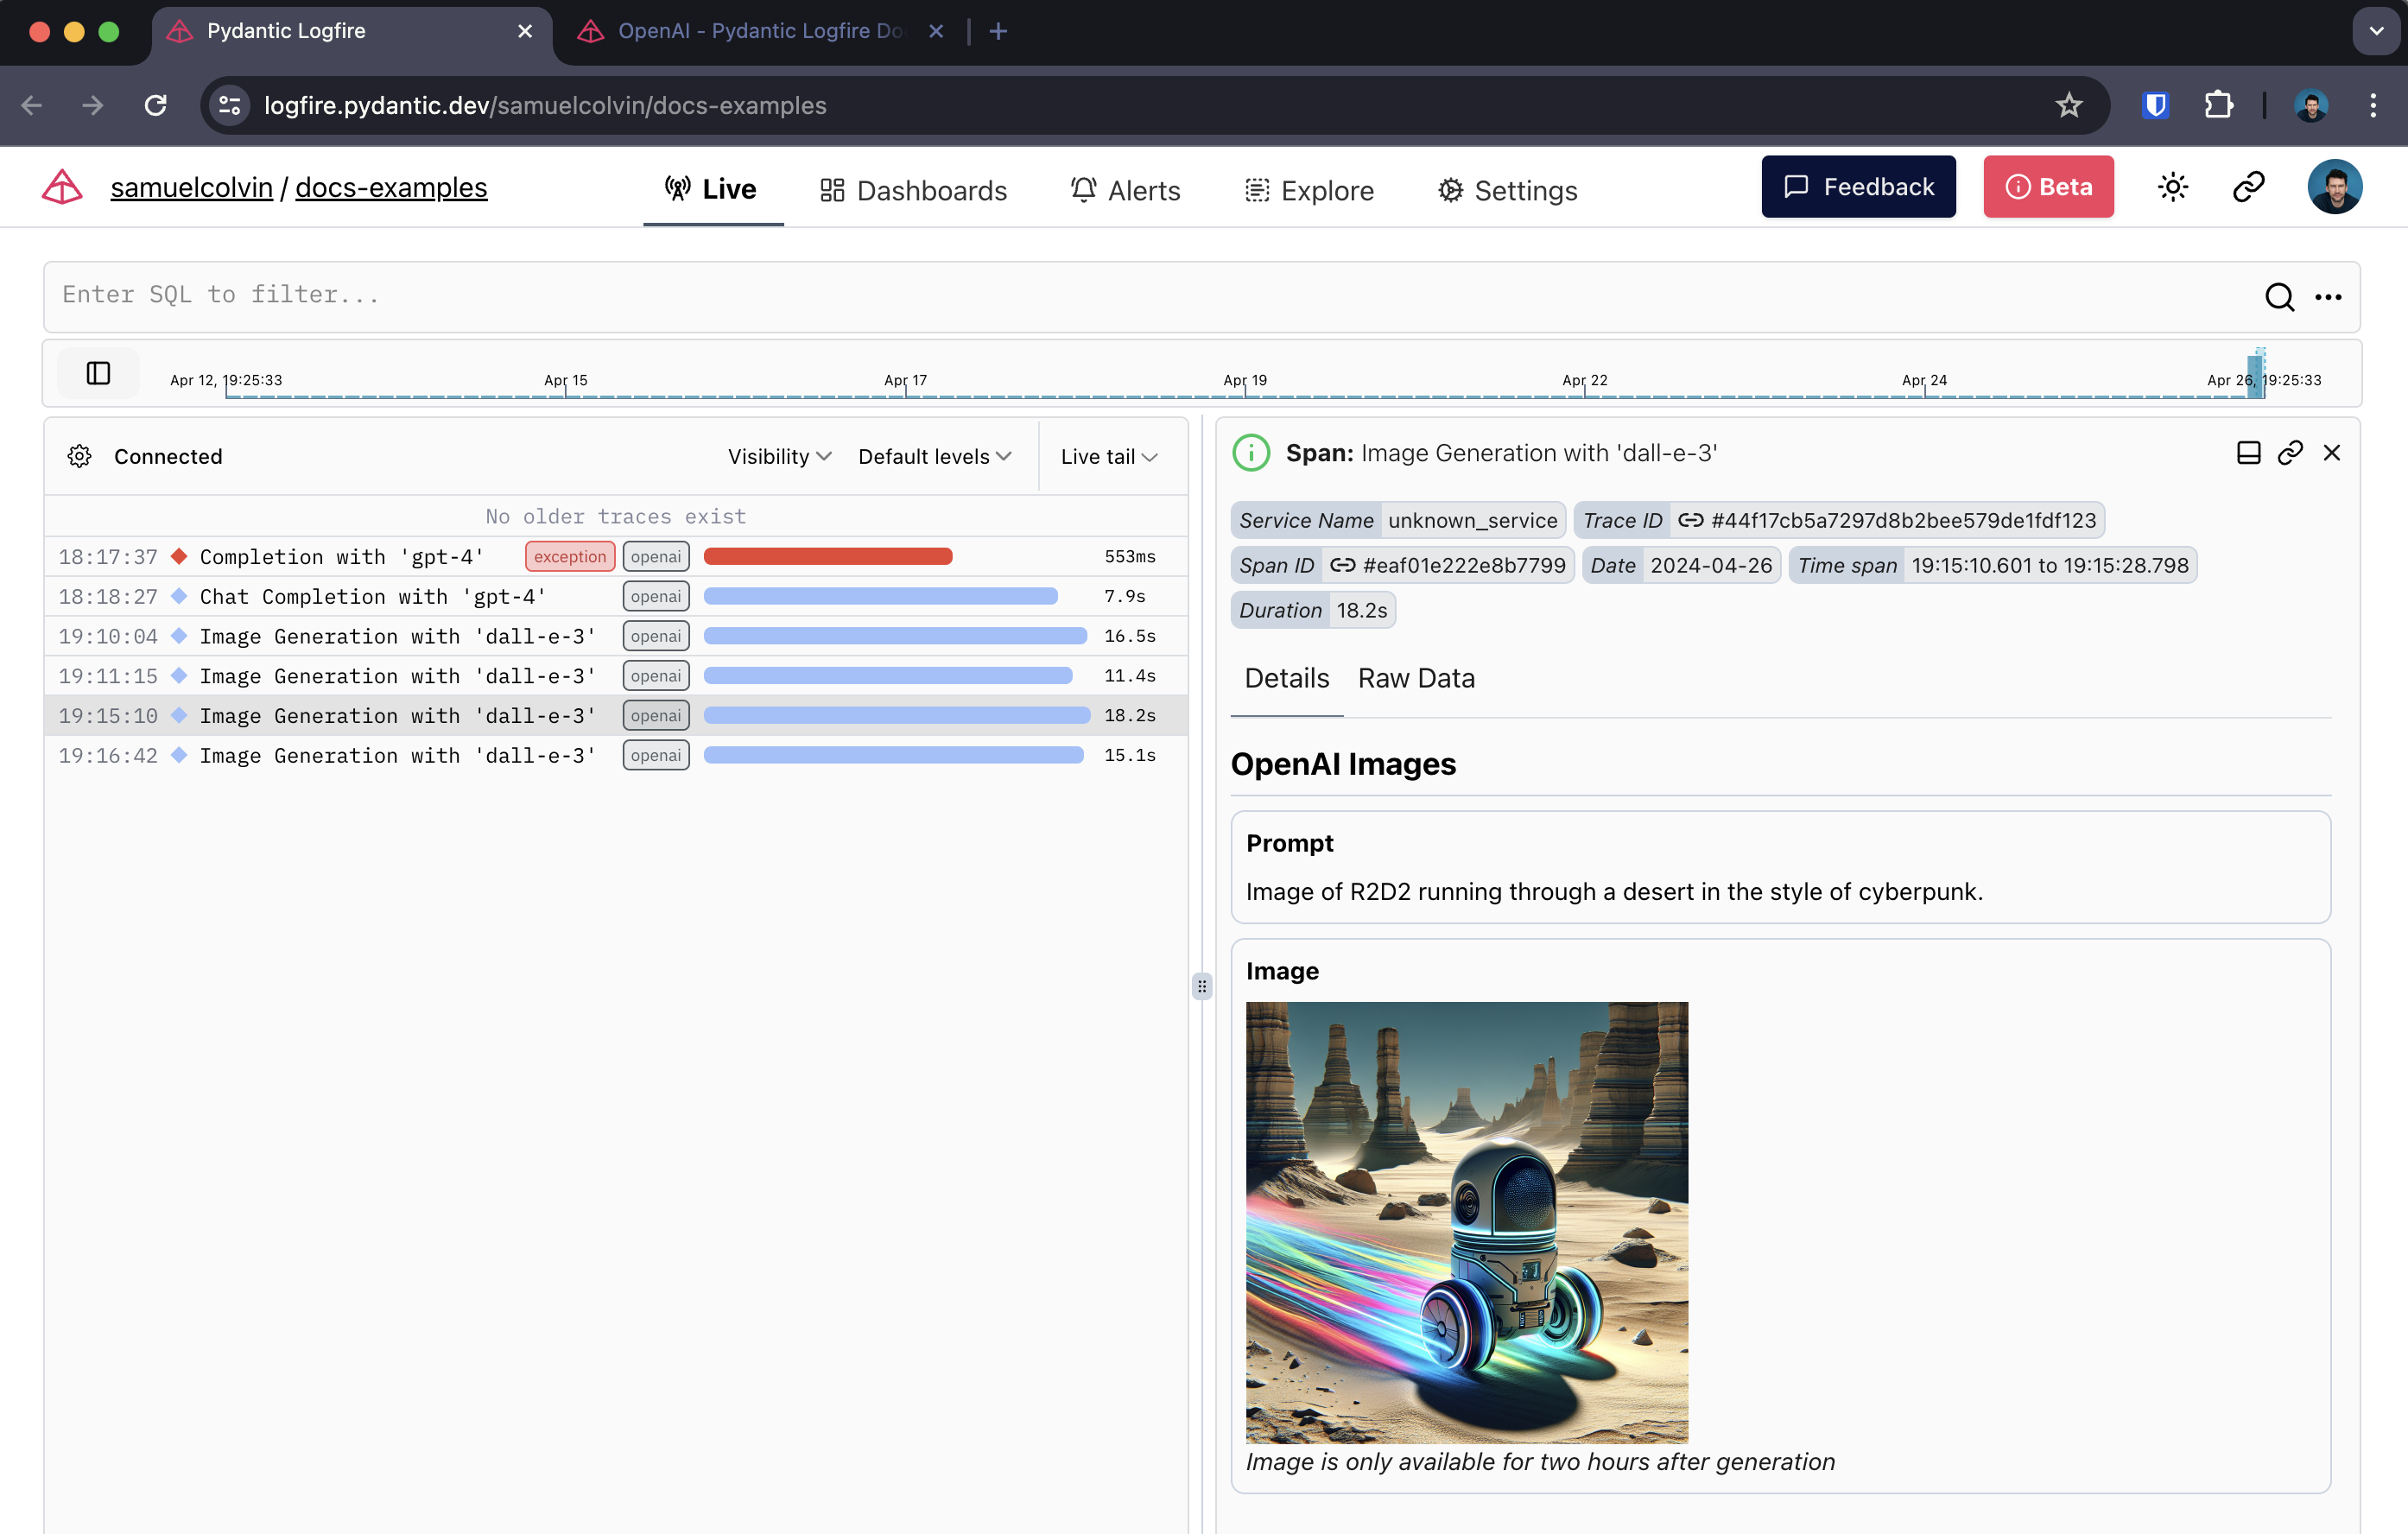
OpenAI beeldgeneratie span
streaming reactie
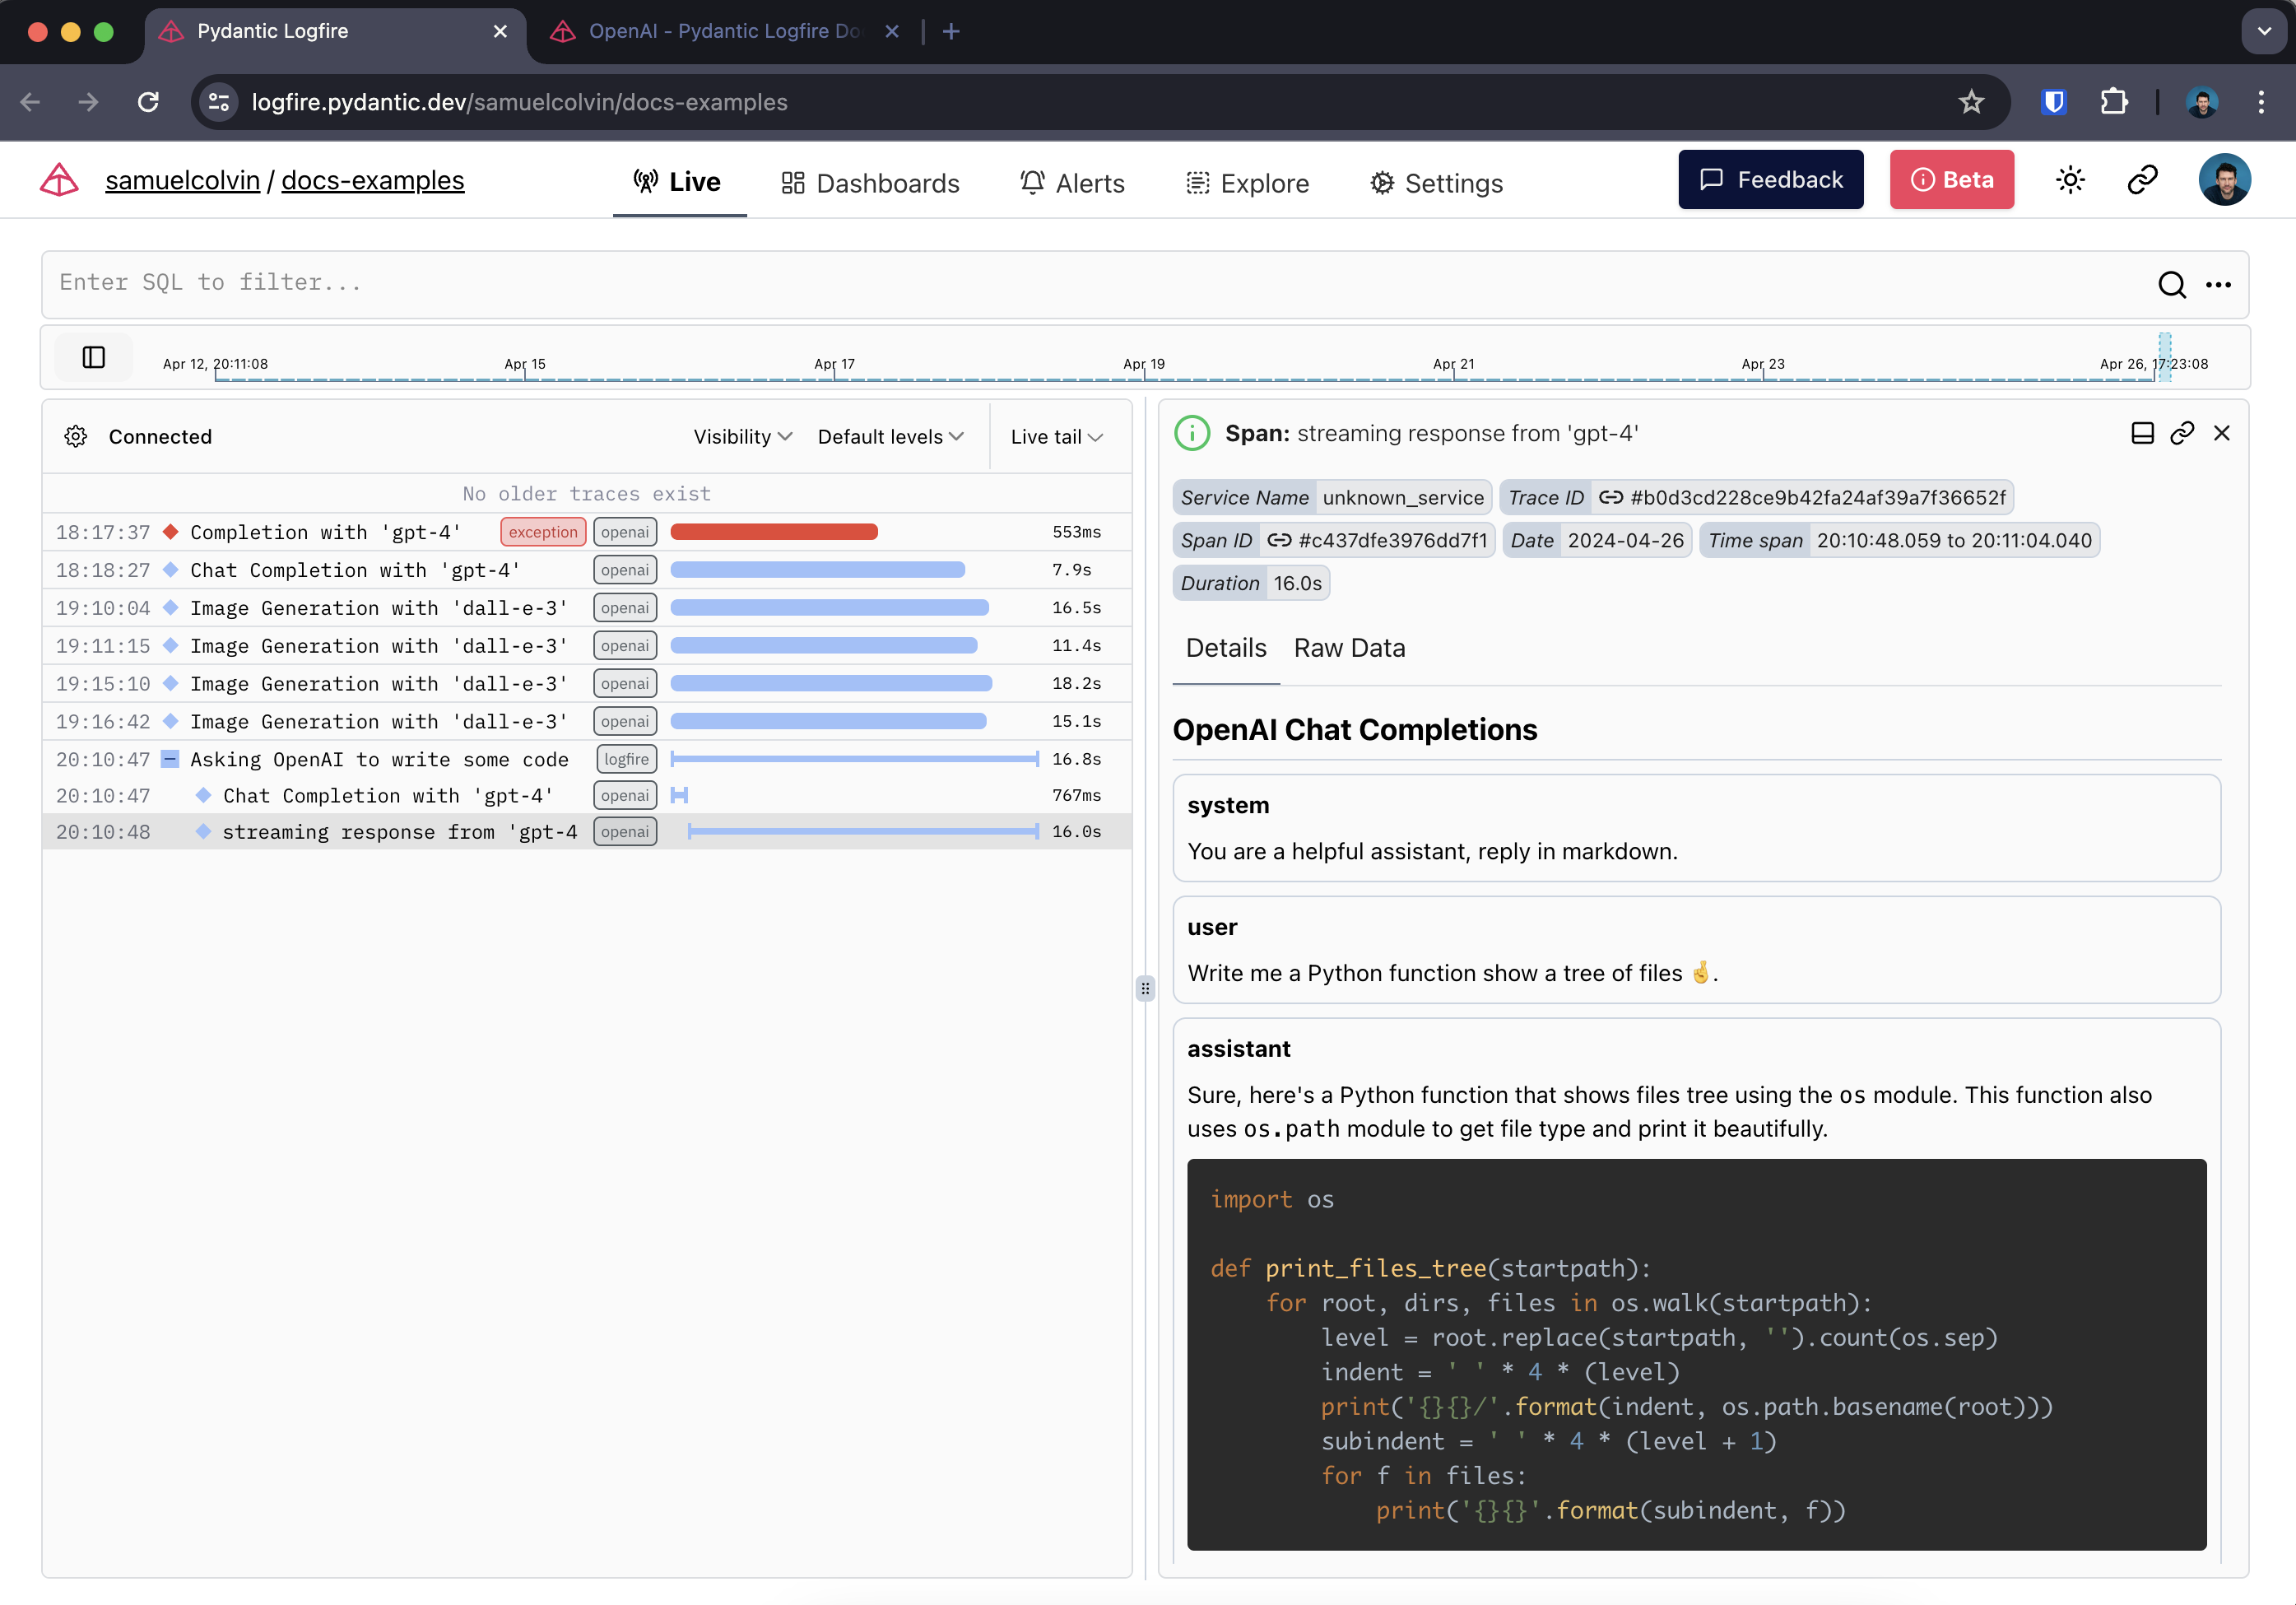
Bij het detecteren van een streamingreactie creëert Logfire twee overspanningen: één rond het eerste verzoek en één rond het streamingantwoord.
Hier gebruiken we ook Rich 's Live en Markdown types om de respons in realtime in het eindpunt weer te geven.: Danser:
import openai
import logfire
from rich.console import Console
from rich.live import Live
from rich.markdown import Markdown

client = openai.AsyncClient()
logfire.configure()
logfire.instrument_openai(client)

async def main():
    console = Console()
    with logfire.span('Asking OpenAI to write some code'):
        response = await client.chat.completions.create(
            model='gpt-4',
            messages=[
                {'role': 'system', 'content': 'Reply in markdown one.'},
                {'role': 'user', 'content': 'Write Python to show a tree of files 🤞.'},
            ],
            stream=True
        )
        content = ''
        with Live('', refresh_per_second=15, console=console) as live:
            async for chunk in response:
                if chunk.choices[0].delta.content is not None:
                    content += chunk.choices[0].delta.content
                    live.update(Markdown(content))

if __name__ == '__main__':
    import asyncio
    asyncio.run(main())
In Logfire ziet het er zo uit:
本文总阅读量次