Handmatige tracing toevoegen
Spanwijdte, logboek en tracering
Hier is een eenvoudig voorbeeld van het gebruik van Logfire:
import time

import logfire

logfire.configure()

with logfire.span('This is a span'):
    time.sleep(1)
    logfire.info('This is an info log')
    time.sleep(2)
Als je dit uitvoert, zou het zoiets als dit moeten afdrukken:
Logfire project URL: https://logfire.pydantic.dev/my_username/my_project_name
21:02:55.078 This is a span
21:02:56.084   This is an info log
De URL van het openingsproject moet het volgende weergeven in de Live-weergave:

Het blauwe vak met 1+ geeft aan dat de overspanning 1 direct kind bevat. Klik op het vak om de overspanning uit te breiden om de kinderen weer te geven:

Let op:
-
Elke span of log die in een
with logfire.span(...):-blok wordt gemaakt, is een kind van die span. Hiermee kun je je logs mooi ordenen in een gestructureerde boom. Je kunt deze ouder-kind-relatie ook bekijken in een indent-based console-log. -
Overspanningen hebben een starttijd en een eindtijd, en dus een duur. Deze overspanning duurt 3 seconden om te voltooien.
-
Voor logs zijn de begin- en eindtijden hetzelfde, dus ze hebben geen duur. Je kunt echter nog steeds in de gebruikersinterface zien dat logs worden gemaakt 1 seconde nadat de span begint en 2 seconden voordat de span eindigt.
Als u op de link "Verkennen" in de bovenste navigatiebalk klikt, kunt u SQL schrijven om verder te verkennen, bijvoorbeeld:
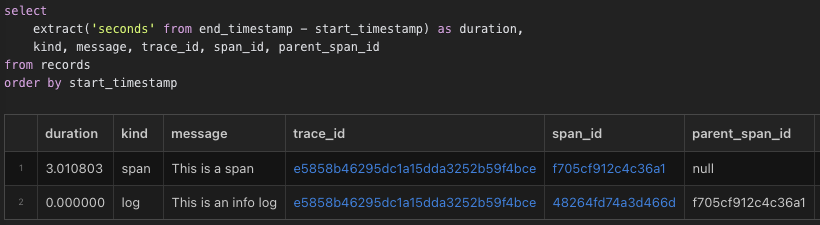
Opgelet:
-
Overspanningen en logboeken worden samen opgeslagen in dezelfde
记录-tabel. -
De log
的parent_span_idis de overspanning vanspan_id. -
Beide hebben dezelfde
trace_id. Je kunt erop klikken om in de "live" weergave een nieuw tabblad te openen, dat gefilterd is naar die_trace_.
_trace_is een span / log tree die dezelfde root deelt. Elke keer dat een nieuwe span / log wordt gemaakt zonder een actieve span, wordt er een nieuwe trace gemaakt. Als het een span is, zullen alle afstammelingen van die span deel uitmaken van dezelfde trace. Om logboeken goed in sporen te ordenen, kunt u het beste overspanningen op het hoogste niveau maken om geavanceerde bewerkingen weer te geven, zoals het verwerken van webserververzoeken.
attribuut
Overspanningen en logboeken kunnen worden toegevoegd met gestructureerde gegevens, zoals:
logfire.info ('Hallo', naam = 'Wereld')
Als u klikt op de "Hallo" log in Live View, ziet u het volgende in het detailpaneel aan de rechterkant:
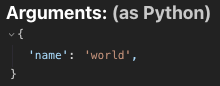
Deze gegevens worden opgeslagen in JSON-formaat in de 属性-kolom van de 记录-tabel. U kunt bijvoorbeeld attributes->>'name' = 'world' gebruiken in het SQL-filter bovenaan de liveweergave om alleen dit logboek weer te geven. Dit wordt gebruikt als de WHERE-clausule van de SQL-query in de 记录-tabel.
Zowel overspanningen als logboeken kunnen eigenschappen hebben die willekeurige waarden bevatten die intelligent naar JSON worden geserialiseerd als dat nodig is. U kunt elk zoekwoordargument doorgeven om eigenschappen in te stellen, zolang ze niet beginnen met een onderstrepingsteken (_).
Deze naamruimte is gereserveerd voor aanvullende zoekwoordparameters met logfire-specifieke betekenissen.
Soms is het handig om eigenschappen aan een scope te koppelen nadat deze is gemaakt, maar voordat deze is voltooid. U kunt dit doen door de span.set_attribute-methode aan te roepen:
with logfire.span('Calculating...') as span:
    result = 1 + 2
    span.set_attribute('result', result)
Bericht en span namen
Als u deze code uitvoert:
import logfire

logfire.configure()

for name in ['Alice', 'Bob', 'Carol']:
    logfire.info('Hello {name}', name=name)
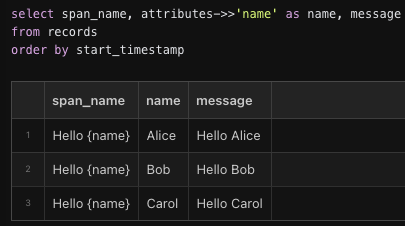
Hier zie je:
-
Het eerste argument,
“Hello {name}”, wordt de waarde van despan_name-kolom. Je kunt het gebruiken om alle records uit dezelfde code te vinden, zelfs als de berichten anders zijn, bijvoorbeeld met behulp van het SQL-filterspan_name = 'Hello {name}'. -
De naam van de span wordt ook gebruikt als een sjabloon in
str.format-stijl die is opgemaakt met eigenschappen om een消息-kolom te genereren. Het bericht wordt weergegeven in het console-logboek en in de liveweergave.
U kunt span.message ook instellen nadat de overspanning is begonnen, maar voordat de overspanning is voltooid, bijvoorbeeld:
with logfire.span('Calculating...') as span:
    result = 1 + 2
    span.message = f'Calculated: {result}'
U kunt 消息 gebruiken om gerelateerde records te filteren, zoals “Hello%”之类的消息, maar het filteren van een span_name-kolom is efficiënter omdat deze is geïndexeerd. Nogmaals, het gebruik van span_name = 'Hello {name}' 和 attributes->>'name' = 'Alice' is beter dan het gebruik van message = 'Hello Alice'.
Om gerelateerde records effectief te kunnen filteren, moet de_-kardinaliteit_van span-namen laag zijn, wat betekent dat ze niet te veel mogen variëren. Dit zou bijvoorbeeld slecht zijn:
name = get_username()
logfire.info('Hello ' + name, name=name)
Want nu zal de span_name kolom voor elke gebruikersnaam een andere waarde hebben. Maar dat is prima:
Omdat de span_name-kolom nu slechts twee waarden heeft ('Goodbye {name}' en 'Hello {name}'), is het filteren van span_name = 'Hello {name}' eenvoudiger en efficiënter dan het filteren van span_name = '{word} {name}' 和 attributes->>'word' = 'Hello'.
Als u wilt dat de naam van de span verschilt van de berichtsjabloon, kunt u de parameter _span_name gebruiken, bijvoorbeeld:
word = 'Goodbye' if leaving else 'Hello'
logfire.info(word + ' {name}', name=name)
Dit stelt span_name in op “Hello” en 消息 op “Hello world”。 Merk op dat de _span_name-parameter begint met een onderstrepingsteken om deze van de eigenschap te onderscheiden.
logfire.info('Hello {name}', name='world', _span_name='Hello')
f-snaren
In plaats daarvan:
logfire.info('Hello {name}', name=name)
Het is veel handiger om F-String te gebruiken om te voorkomen dat NAME driemaal wordt herhaald:
logfire.info(f'Hello {name}')
In tegenstelling tot de vorige paragraaf is dit in Python 3.11 +_werking_Goed, want Logfire zal speciale magie gebruiken om span_name Instellen op “Hello {name}” En zal name Eigenschap is ingesteld op name De waarde van de variabele, dus het is gelijk aan het vorige codefragment. Dit is wat u moet weten:
-
Deze functie is standaard ingeschakeld in Python 3.11 +. Je kunt het uitschakelen met [
logfire.configure(inspect_arguments=False)][logfire.configure(inspect_arguments)]. Je kunt het ook inschakelen in Python 3.9 en 3.10, maar het is waarschijnlijker dat het niet goed werkt. -
Onder normale omstandigheden moeten controleparameters altijd geldig zijn. Het is belangrijk op te merken dat de broncode beschikbaar moet zijn, dus als u bijvoorbeeld alleen het
.pyc-bestand implementeert, mislukt het. -
Als het controleren van parameters mislukt, ontvangt u een waarschuwing en wordt de f-string-parameter gebruikt als opmaaksjabloon. Dit betekent dat u een naam met een hoge kardinaliteit krijgt, zoals
“Hello Alice”, en geen名称-kenmerk, maar de informatie gaat niet volledig verloren. -
Als het controleren van parameters is ingeschakeld, worden parameters gecontroleerd of f-string al dan niet wordt gebruikt. Dus als u
logfire.info('Hello {name}', name=name)schrijft en het controleren van parameters mislukt, krijgt u nog steeds een waarschuwing. -
Waarden in f-strings worden opnieuw geëvalueerd en opgemaakt door Logfire. Dit betekent dat als
get_username()(of stringconversie van alles wat het retourneert) duur is of bijwerkingen heeft, u geen code zoalslogfire.info(f'Hello {get_username()}')moet gebruiken. -
Het eerste argument moet de eigenlijke f-string zijn.
logfire.info(f'Hello {name}')zal werken, maarmessage = f'Hello {name}'; logfire.info(message)niet, enlogfire.info('Hello ' + name)ook niet. -
Het controleren van parameters wordt in de cache opgeslagen, zodat herhaalde controle van dezelfde f-string minimale prestatieoverhead heeft. Het parseren van grote bronbestanden brengt echter aanzienlijke overhead met zich mee bij het controleren van parameters voor de eerste keer. Hoe dan ook, het vermijden van deze overhead vereist het volledig uitschakelen van controleparameters, niet alleen het vermijden van f-strings.
abnormaal
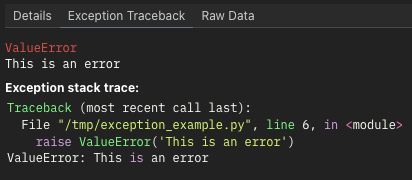
logfire.span De contextmanager registreert automatisch alle uitzonderingen waardoor deze is afgesloten, zoals:
import logfire

logfire.configure()

with logfire.span('This is a span'):
    raise ValueError('This is an error')
Als u in Live View op Spans klikt, wordt er een tabblad "Exception Traceback" in het rechterpaneel weergegeven:
Uitzonderingen die worden gevangen maar niet opnieuw worden uitgeroeid, worden niet geregistreerd, bijvoorbeeld:
with logfire.span('This is a span'):
    try:
        raise ValueError('This is an acceptable error not worth recording')
    except ValueError:
        pass
Als u afgehandelde uitzonderingen wilt loggen, gebruikt u span.record_exception Werkwijze:
with logfire.span('This is a span') as span:
    try:
        raise ValueError('Catch this error, but record it')
    except ValueError as e:
        span.record_exception(e)
Of, als u alleen uitzonderingen wilt loggen zonder overspanningen te maken voor normale gevallen, kunt u logfire.exception gebruiken:
try:
    raise ValueError('This is an error')
except ValueError:
    logfire.exception('Something went wrong')
logfire.exception(...) is gelijk aan logfire.error(..., _exc_info=True)。. Als u tracebacks op niet-foutniveau wilt loggen, kunt u _exc_info ook gebruiken met andere logmethoden. Als het uitzonderingsobject niet het object is dat wordt verwerkt, kunt u _exc_info instellen als het uitzonderingsobject. Vergeet het leidende onderstrepingsteken niet!
Handige functionele overspanning met @logfire.instrument
Meestal wil je de hele functie in een span verpakken. In plaats van dit te doen:
def my_function(x, y):
    with logfire.span('my_function', x=x, y=y):
        ...
U kunt de @logfire.instrument -decorateur gebruiken:
Dit voegt standaard functieparameters toe als eigenschappen aan de overspanning. Om deze functie uit te schakelen (als de parameter bijvoorbeeld een groot object is dat het verzamelen niet waard is), gebruikt u instrument(extract_args=False)。
De standaard span naam is vergelijkbaar met Calling module_name.my_function U kunt een alternatieve span-naam als eerste argument doorgeven aan instrument Het kan zelfs worden opgemaakt als een argument voor een sjabloon, zoals:
@logfire.instrument('Applying my_function to {x=} and {y=}')
def my_function(x, y):
    ...

my_function(3, 4)
# Logs: Applying my_function to x=3 and y=4
Aandacht
- '@ Logfire.instrument' Decorateurs moeten eerst worden aangebracht, dat wil zeggen onder een andere decorateur.
- De broncode van een functie moet toegankelijk zijn.
log niveau
De methoden voor het maken van verschillende niveaus van logboeken zijn als volgt:
logfire.tracelogfire.debuglogfire.infologfire.notice(日志火灾通知)logfire.warnlogfire.errorlogfire.fatal
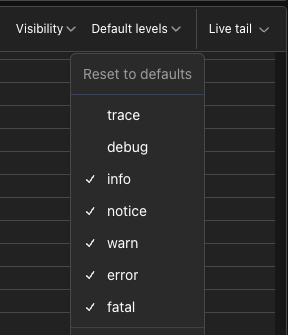
Standaard zijn 跟踪- en 调试-logboeken verborgen. U kunt deze instelling wijzigen door in Live View op het vervolgkeuzemenu "Standaardniveaus" te klikken:
U kunt ook logfire.configure gebruiken om een minimumniveau voor console-logging in te stellen, zoals:
import logfire

logfire.configure(console=logfire.ConsoleOptions(min_log_level='debug'))
Om berichten met een variabel niveau te loggen, kunt u logfire.log gebruiken, bv.logfire.log('info', 'This is an info log') is gelijk aan logfire.info('This is an info log')。
Standaard is de span het level 信息. Je kunt deze parameter wijzigen met de _level parameter, bijvoorbeeld 使用 logfire.span('This is a debug span', _level='debug'):. Je kunt het level ook wijzigen met span.set_level nadat de span is gestart maar voordat de span is afgelopen. LogfireSpan. set _ level], bijvoorbeeld:
with logfire.span('Doing a thing') as span:
    success = do_thing()
    if not success:
        span.set_level('error')
In de "real-time" weergave,De overspanning is gekleurd volgens zijn hoogste rang en zijn nakomelingenBijvoorbeeld de volgende code:
import logfire

logfire.configure()

with logfire.span('Outer span'):
    with logfire.span('Inner span'):
        logfire.info('This is an info message')
        logfire.error('This is an error message')
Het zal zo verschijnen:
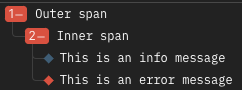
Hier zijn de niveaus van de overspanningen zelf nog steeds ingesteld op 默认-informatie, maar ze zijn rood gekleurd in plaats van blauw omdat ze foutlogboeken bevatten.
Als de span eindigt met een onverwerkte uitzondering, wordt het logniveau van de span ook ingesteld op 错误 naast het loggen van backtraces zoals hierboven beschreven. Dit gebeurt niet bij gebruik van span.record_exception . LogfireSpan.record _ reference] methode.
In de database worden logniveaus opgeslagen als getallen in de 级别 kolom. Deze waarden zijn gebaseerd op OpenTelemetry, b.v.info is 9. U kunt de level_num SQL functie gebruiken om de niveau namen om te zetten naar getallen, b.v.级别 > level_num('info') zal alle "uitzondering" records zoeken.
U kunt ook de level_name SQL-functie gebruiken om getallen om te zetten naar namen, zoals SELECT level_name(level)、... om door mensen leesbare niveaus te zien in de weergave "Verkennen". Merk op dat de level-kolommen zijn geïndexeerd, dus filteren op level = level_num('error') is geldig, maar filteren op level_name(level) = 'error' niet.
本文总阅读量次